


「半導體公司平均淨利率 13%。」這句話把 79 家公司壓縮成一個數字,丟掉了什麼?
FT Visual Vocabulary 的第四欄是「分佈」(Distribution),定義是:呈現資料中各個數值出現的頻率。FT 說,分布的形狀(偏態)常是讓人記住「不平均、不平等」最好的方法,並拿它畫所得分配、人口的年齡與性別分布。
第一篇提過,統計量是一種壓縮,壓縮就一定會丟掉資訊。這一欄的 9 種圖型,就是 9 種把被丟掉的東西找回來的方法。
一、直方圖:先看形狀
FY2025 樣本公司的淨利率長什麼樣子?大多數公司落在哪裡?
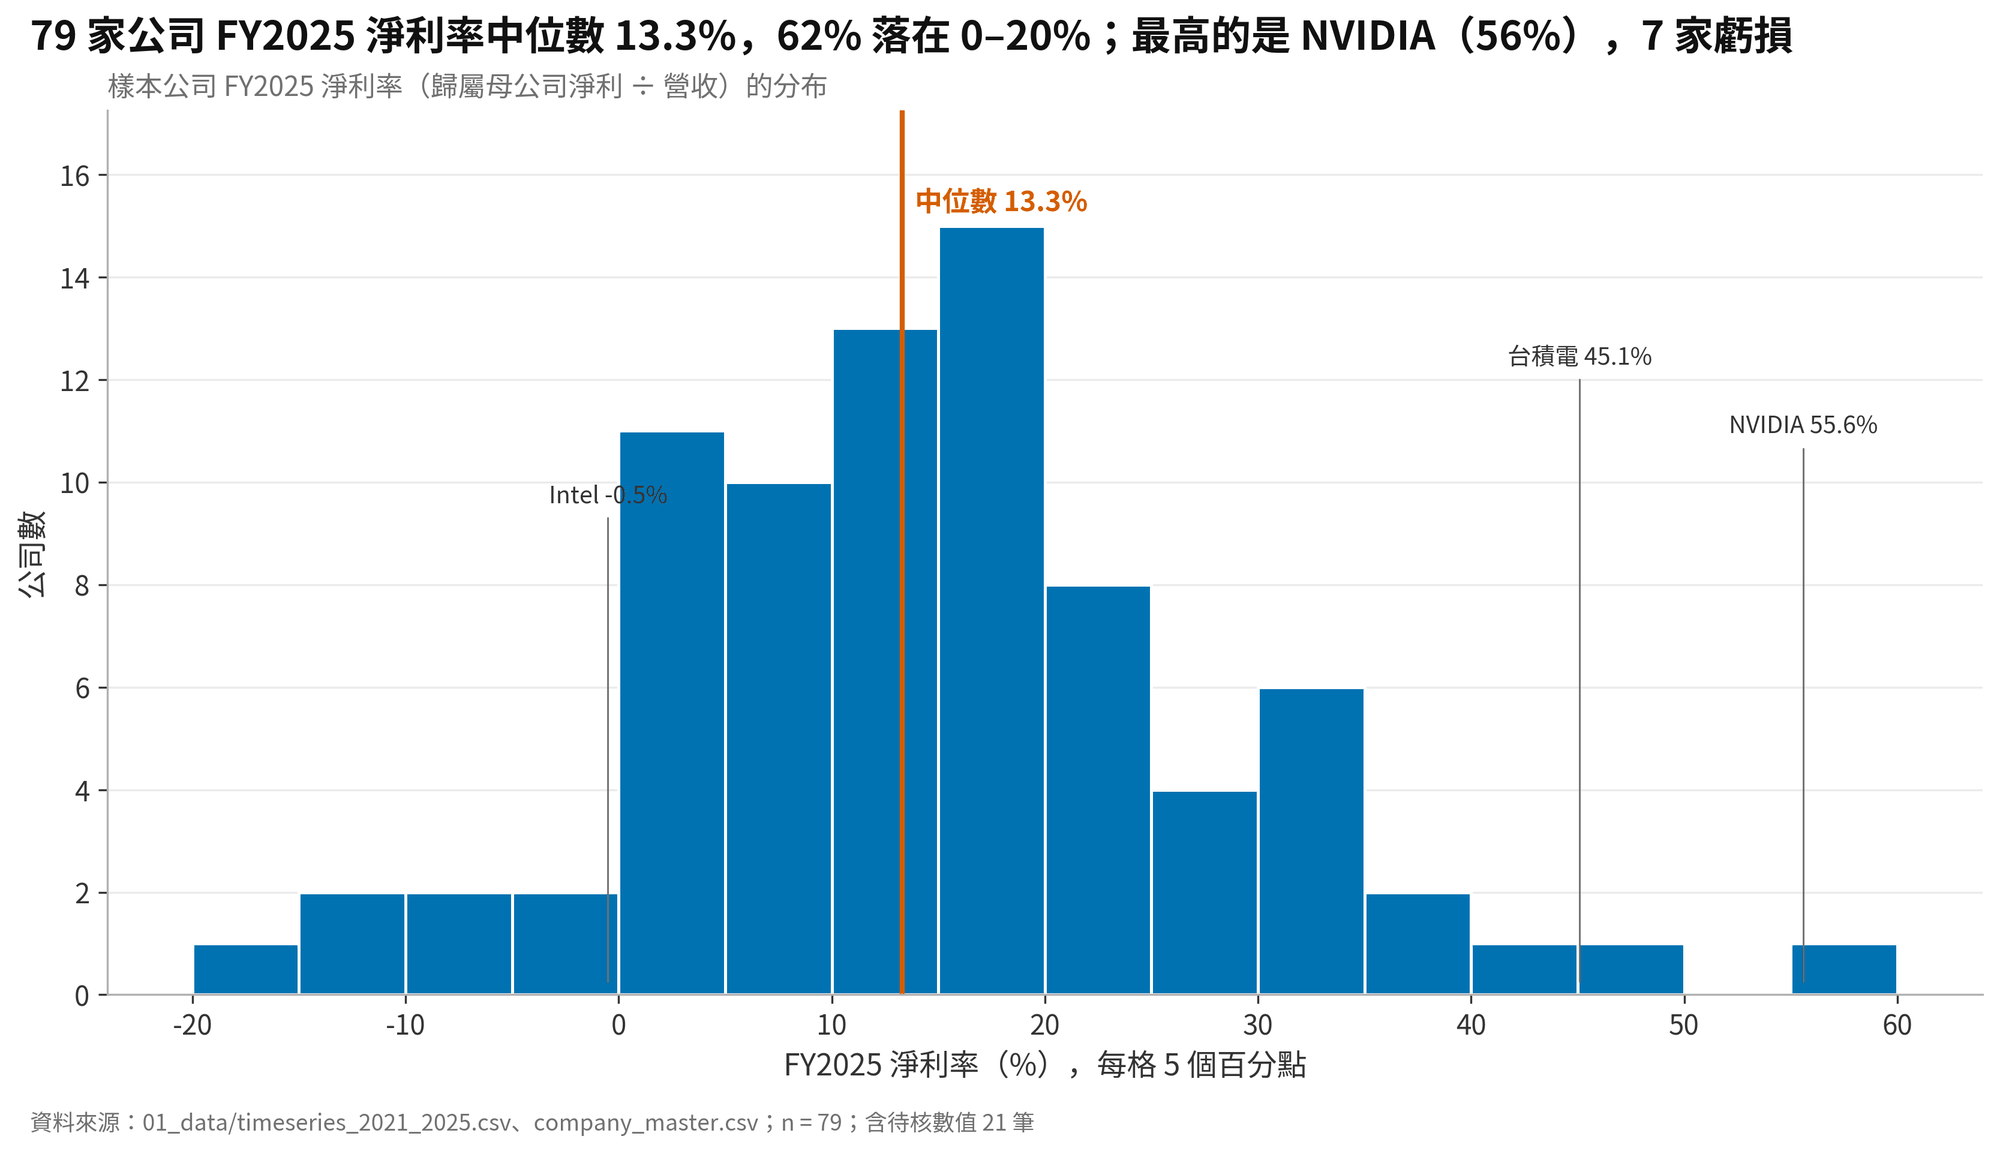
直方圖回答「多少家公司落在這個區間」,看的是形狀:單峰還是雙峰、對稱還是偏一邊、有沒有長尾。這份資料的分布偏右,多數公司擠在 0 到 20% 之間,少數高利潤公司(IC 設計與晶圓代工龍頭)拉出一條右尾;在這種形狀下,平均數 14.7% 會比中位數 13.3% 高。
陷阱有三個。組距是作者選的:這裡每格 5 個百分點,改成 2 或 10,形狀看起來就不一樣。公司數少:79 家公司分到十幾格,每格只有幾家,一家公司移動就會改變形狀。每家公司一票:台積電和一家小公司一樣重,要看「整個產業賺多少」,得用總淨利除以總營收的加權算法。
二、箱形圖:把 14 個分布並排
各產業群的淨利率分布有多不一樣?哪一群內部差距最大?
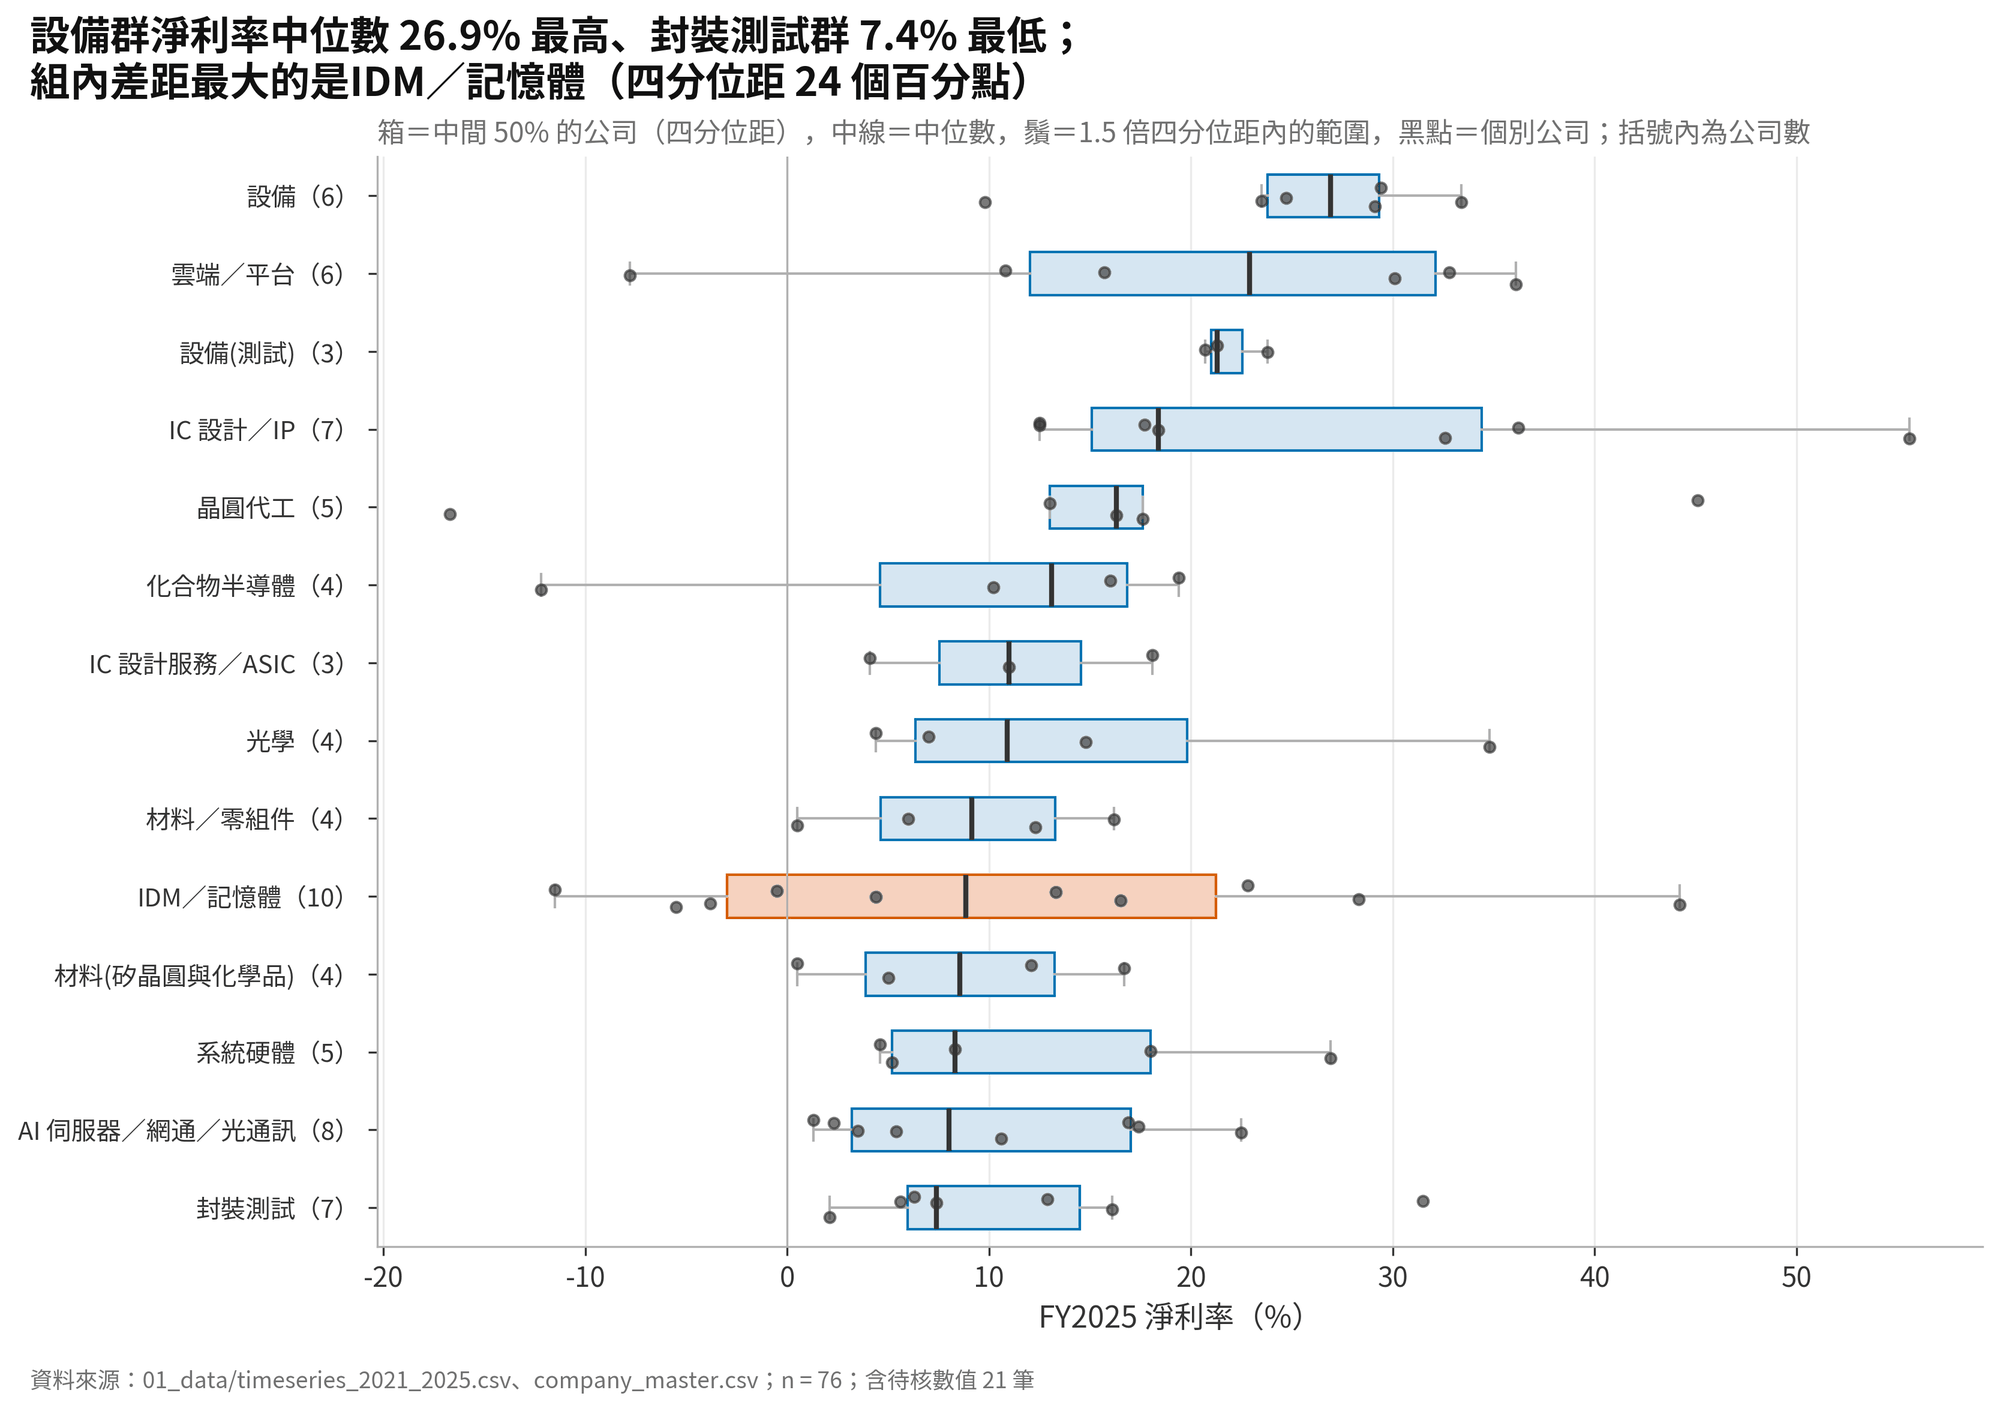
箱形圖用中位數與四分位數概括一組資料,14 個群並排,比 14 張直方圖好比較。這裡還在箱子上疊了每家公司的點,因為每群只有 3 到 10 家,只畫箱子會讓人以為背後有上百個觀察值。
箱形圖有兩個常見的盲點。小樣本的箱子:3 家公司也畫得出箱子,但四分位數幾乎就是那三個點,箱形圖在樣本很小時會「假裝」有分布。箱形圖也會藏起雙峰:如果一群公司一半在 5%、一半在 30%,箱子看起來只是一個很寬的箱子,看不出中間其實是空的。
三、小提琴圖:中位數不動,兩端在拉開
2021 到 2025 年,樣本公司淨利率的整體分布怎麼變?只看中位數會漏掉什麼?
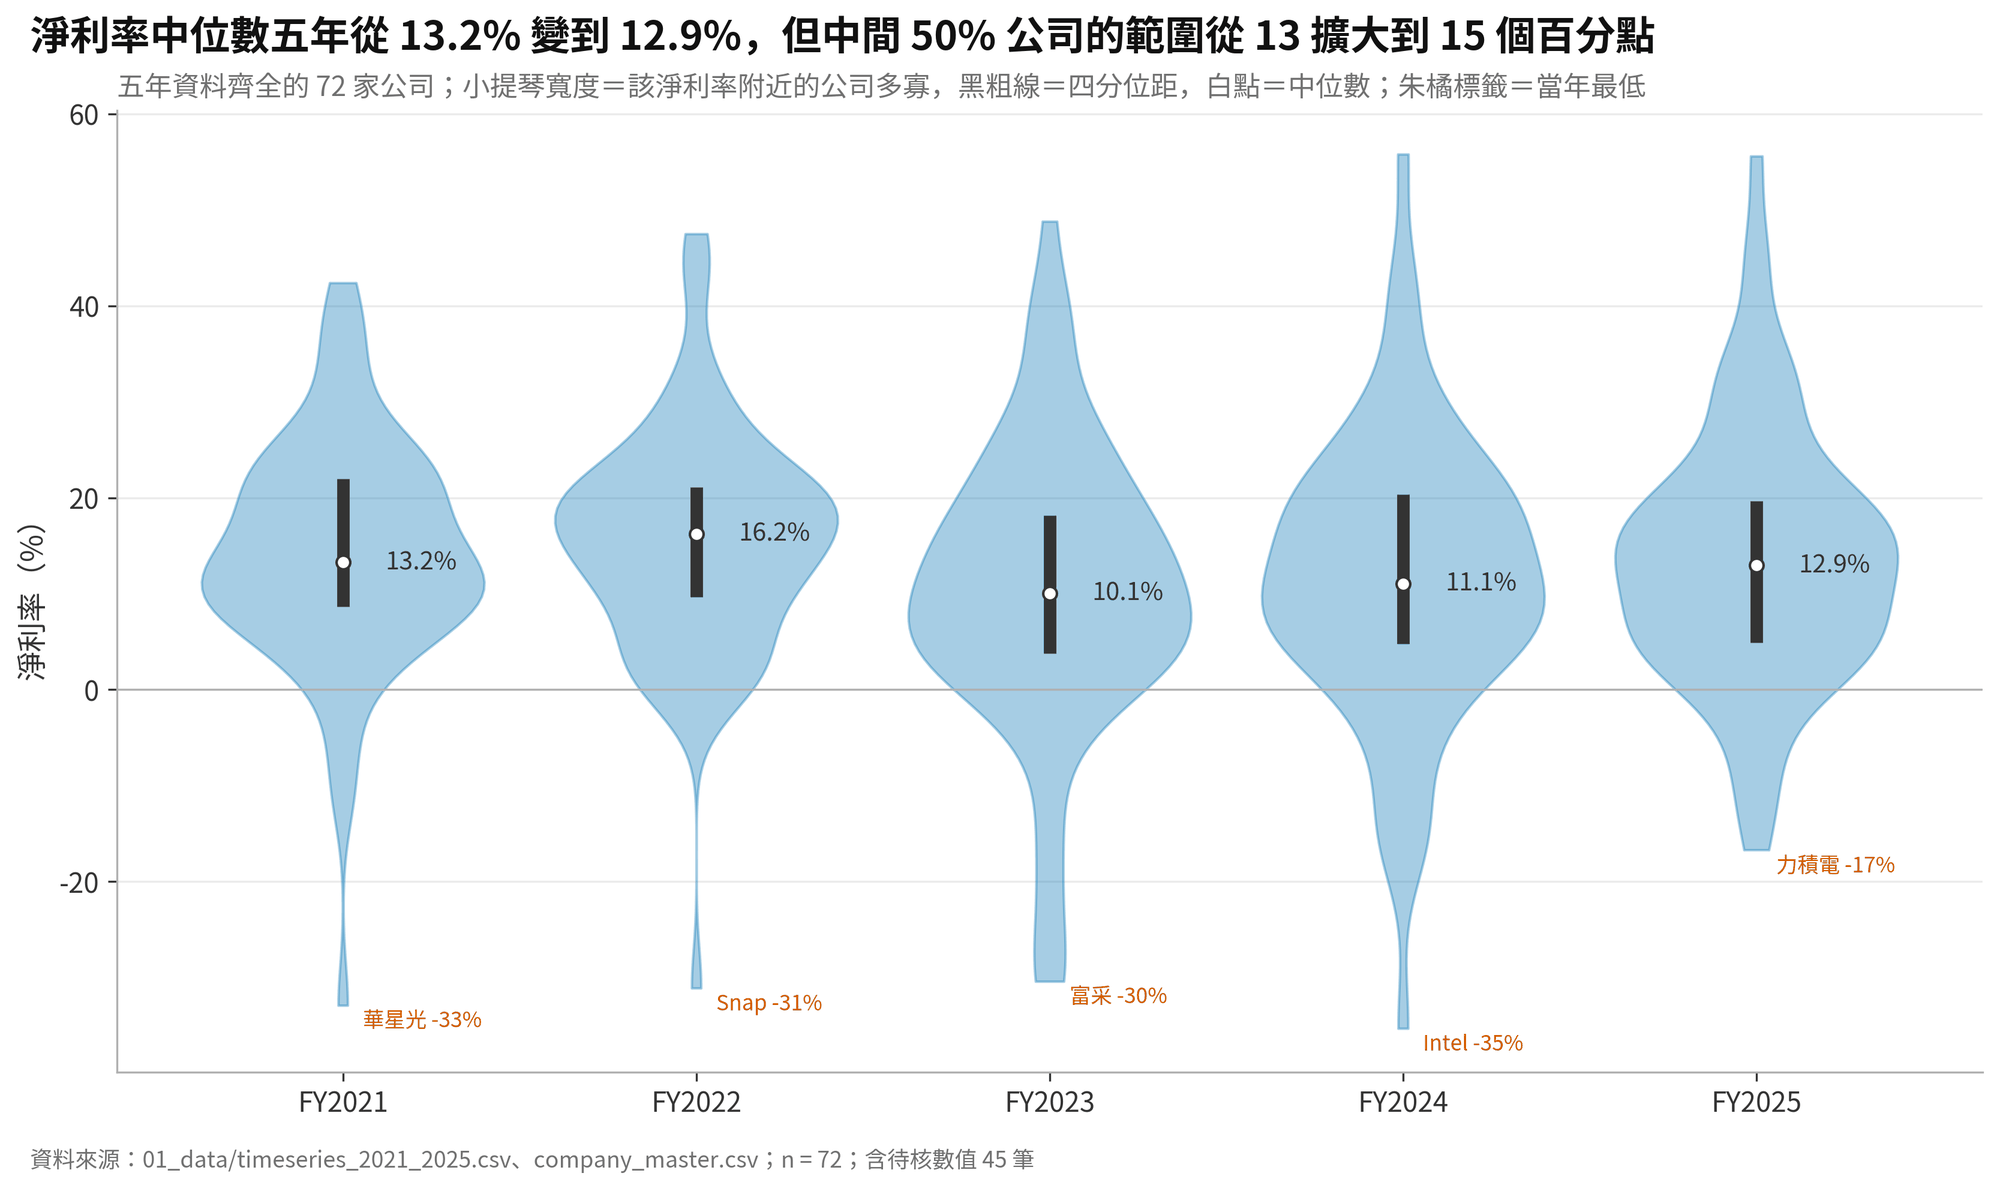
小提琴的寬度是平滑後的密度,哪裡胖,哪裡的公司就多;如果中間有一段細腰,代表資料分成兩群,這是箱形圖看不到的。這裡只用五年資料齊全的公司,否則年與年之間比的是不同的公司。
這張圖最重要的一課是:中位數穩定,不等於沒有變化。五年來中位數幾乎不動,兩端卻在拉開。但小提琴圖也有自己的陷阱:平滑會「發明」資料,尾巴會延伸到沒有公司的地方;平滑的程度也是作者選的,調大會變得圓滑,調小會出現很多小鼓包。
四、人口金字塔:背對背的兩個直方圖
台灣與國際樣本公司的資本支出強度,分布有什麼不同?
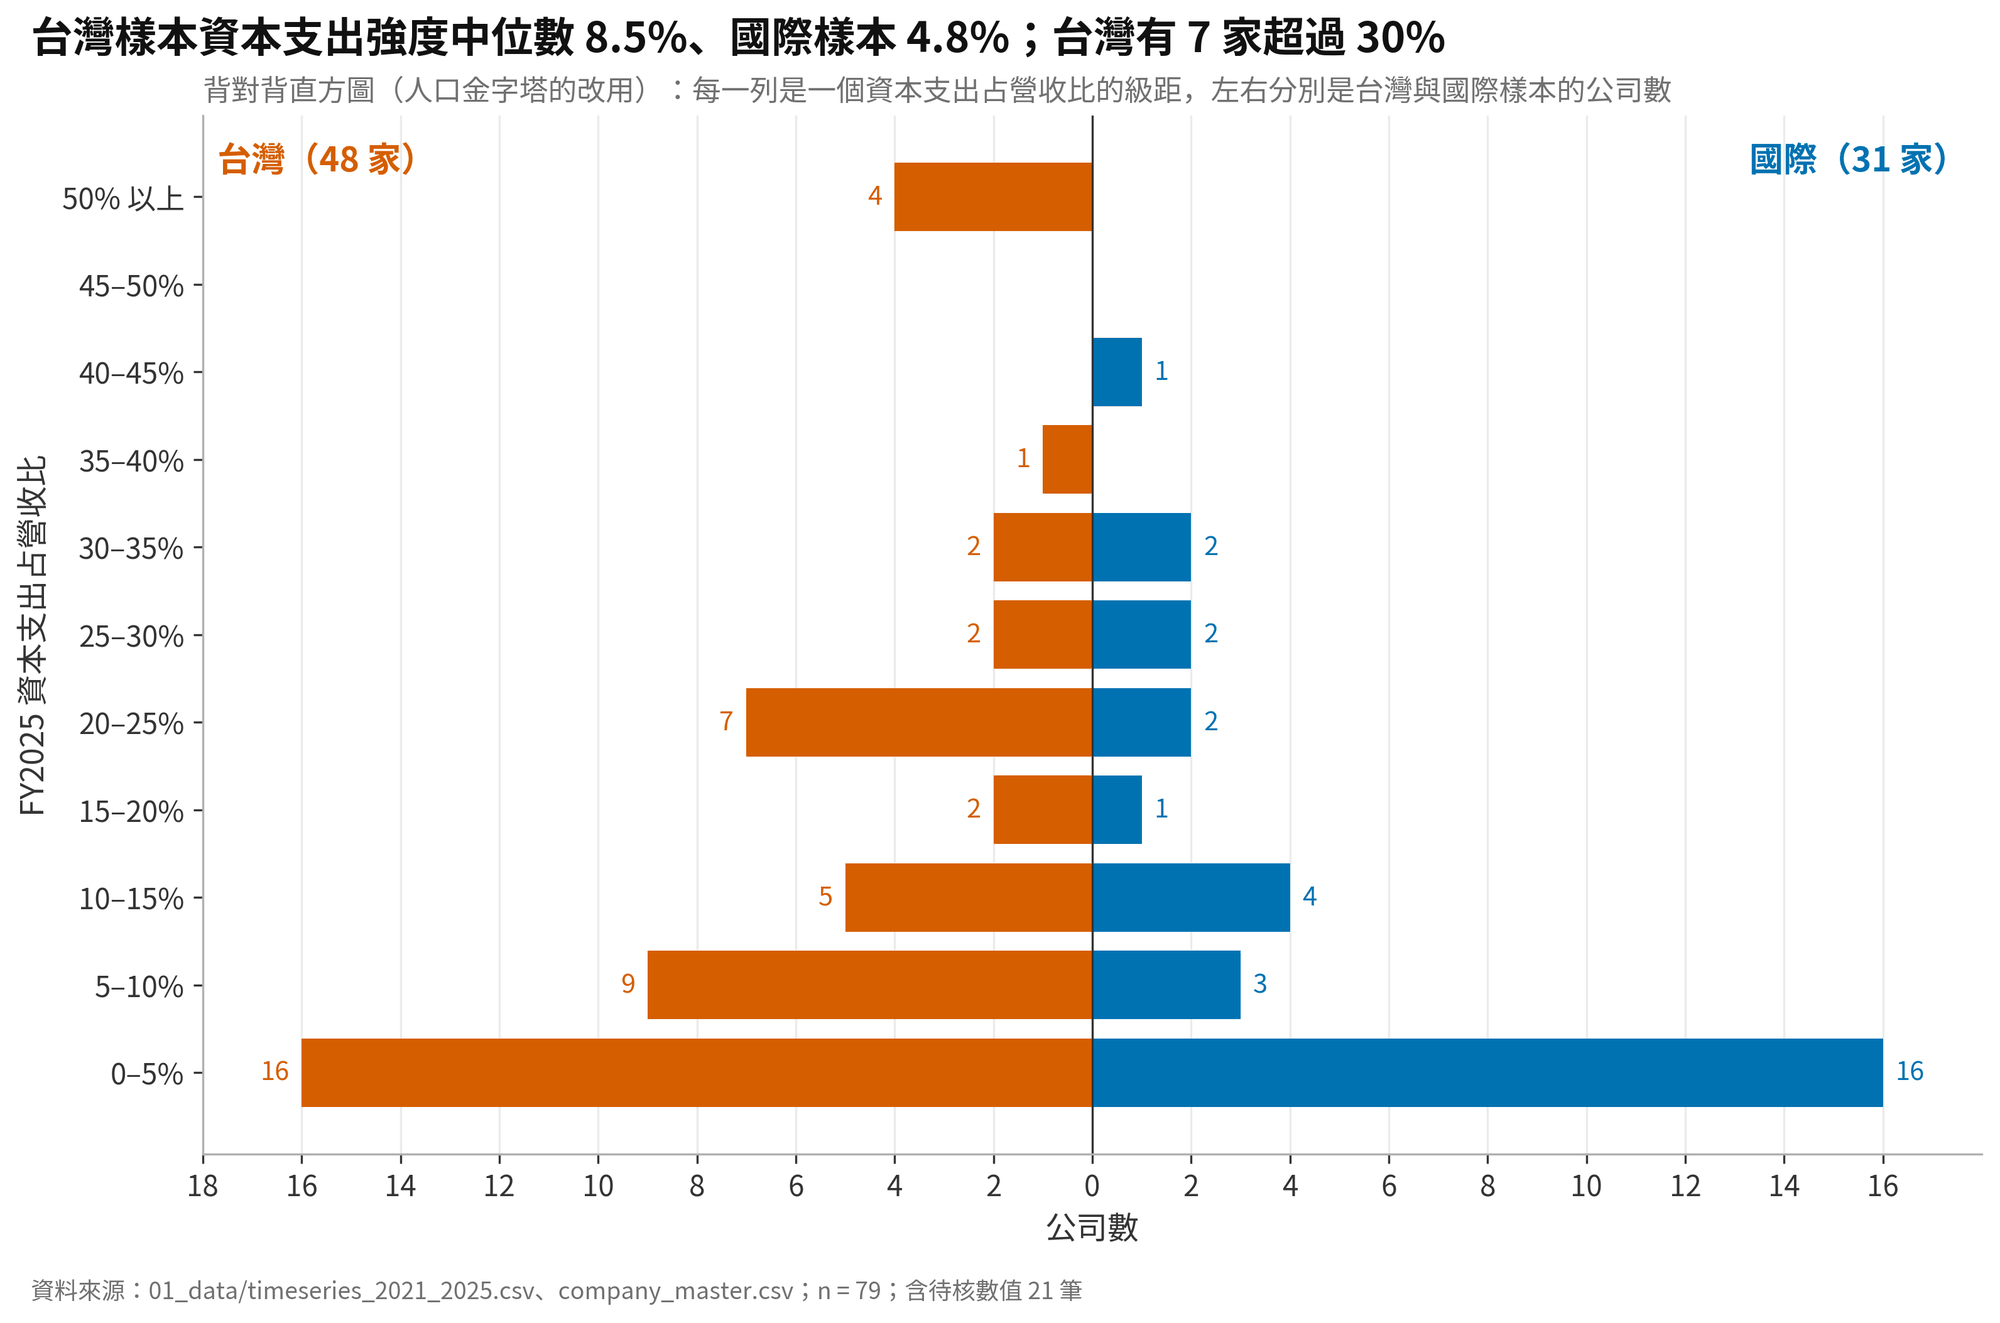
人口金字塔原本是「年齡 × 性別」的背對背直方圖,這裡保留它的結構,換成「資本支出強度 × 台灣/國際」。這是一種改用:人口金字塔的縱軸有自然順序(年齡),資本支出強度也有;沒有自然順序的類別,就不適合這種圖。
陷阱在於兩邊的樣本數不同:台灣 48 家、國際 31 家,左邊自然比較長,所以要比「形狀」而不是比「長度」,或者改成各自的百分比。分布的差異也有一大部分來自產業組成:台灣樣本有較多晶圓廠、封測、材料等重資本產業,國際樣本則有雲端與系統公司,不能因此說「台灣公司比較愛投資」。
五、點狀條紋圖:每一家都畫出來
不同國家的樣本公司,股東權益報酬率(ROE)的分布有什麼差別?
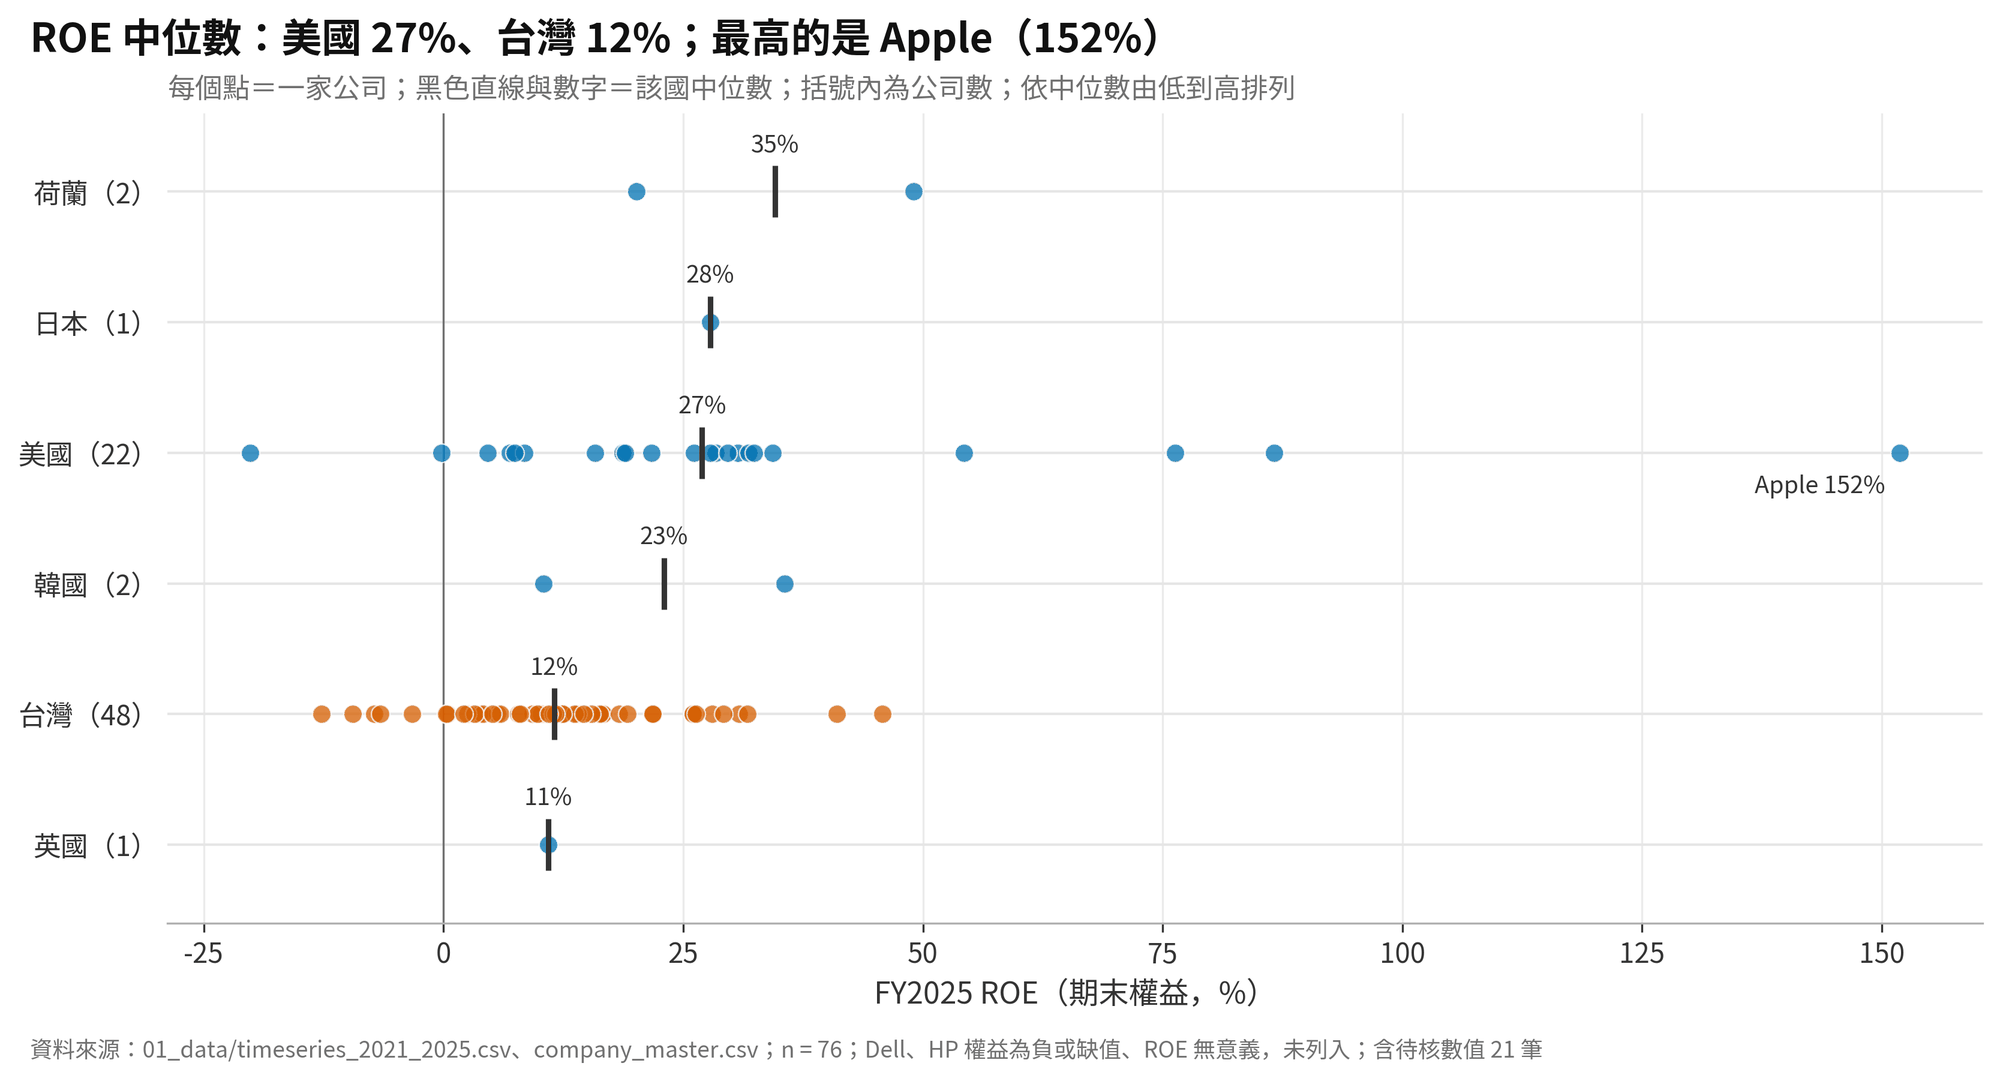
每一列的點數不多,從 1 家到 48 家,把每家公司都畫出來,比畫箱子誠實。權益為負的 Dell、HP,ROE 失去意義,排除並寫在圖註。
這張圖最容易被誤讀成「美國公司比較會賺錢」。但國家不是原因:美國樣本多是軟體、IC 設計、雲端,台灣樣本多是製造、封測、材料,ROE 的差異主要來自產業組成與商業模式。而且 ROE 會被財務槓桿放大,權益越小,ROE 越高,高 ROE 不一定代表經營效率高。韓國、荷蘭、英國、日本只有一兩家公司,中位數幾乎就是那一兩家。
六、點狀圖:範圍有多寬
台灣大公司的淨利率,五年間擺盪的範圍有多大?誰最穩、誰最不穩?
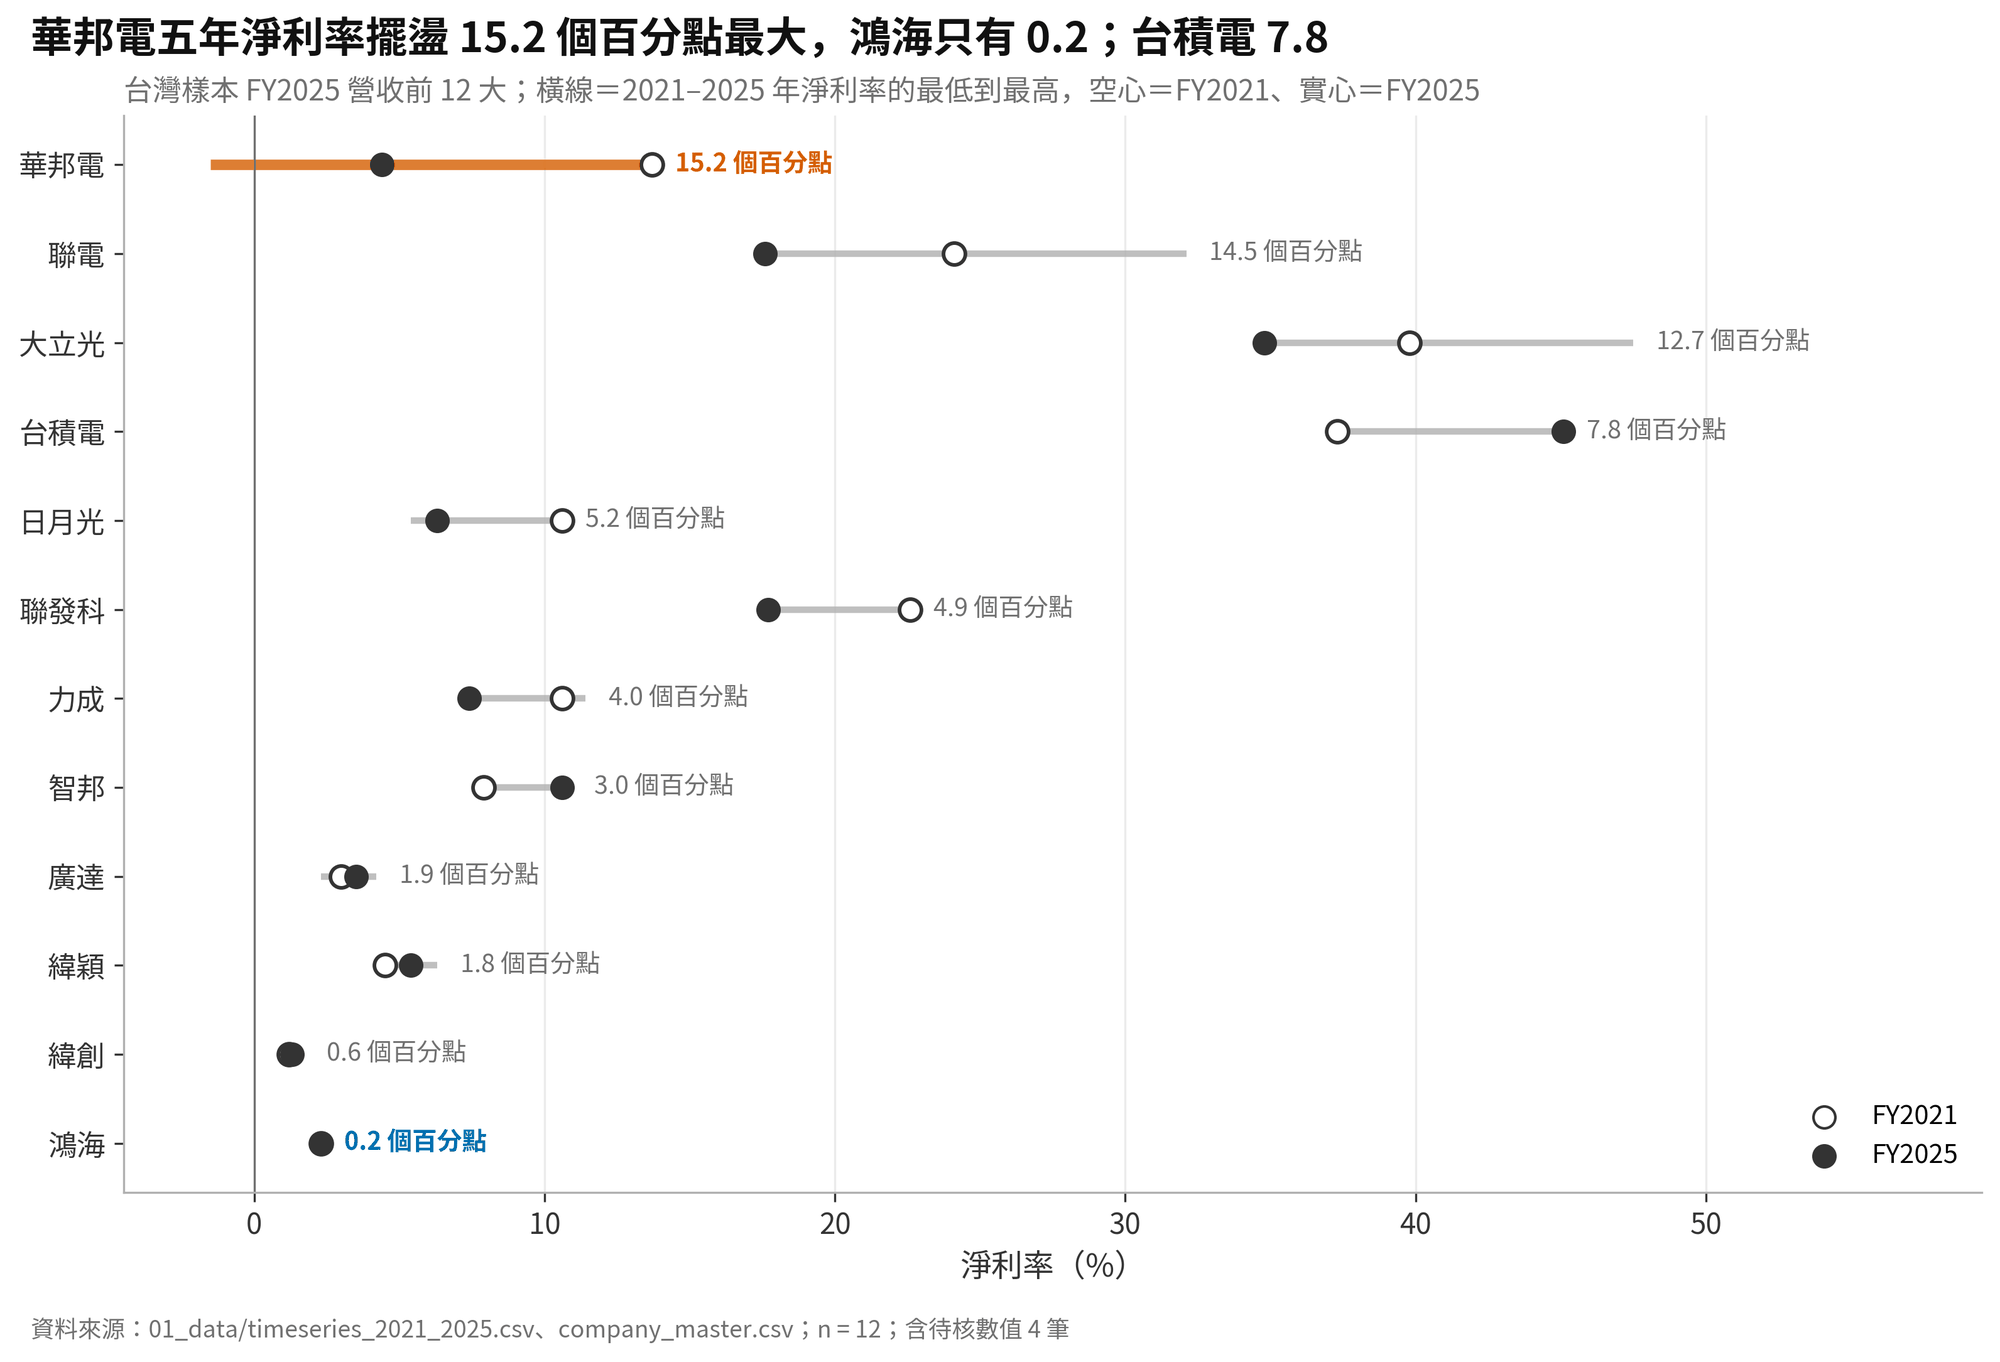
一列一家公司,橫線的長度就是不穩定的程度,兩個點則告訴你頭尾兩年在範圍的哪一端。陷阱是:範圍的最高與最低,不一定出現在頭尾兩年;範圍對極端值很敏感,一年的大虧損就能把線拉得很長;而只選前 12 大公司,本身就偏向比較穩的公司。
七、條碼圖:每家公司一條細線
研發占營收的比重,各家公司落在哪裡?
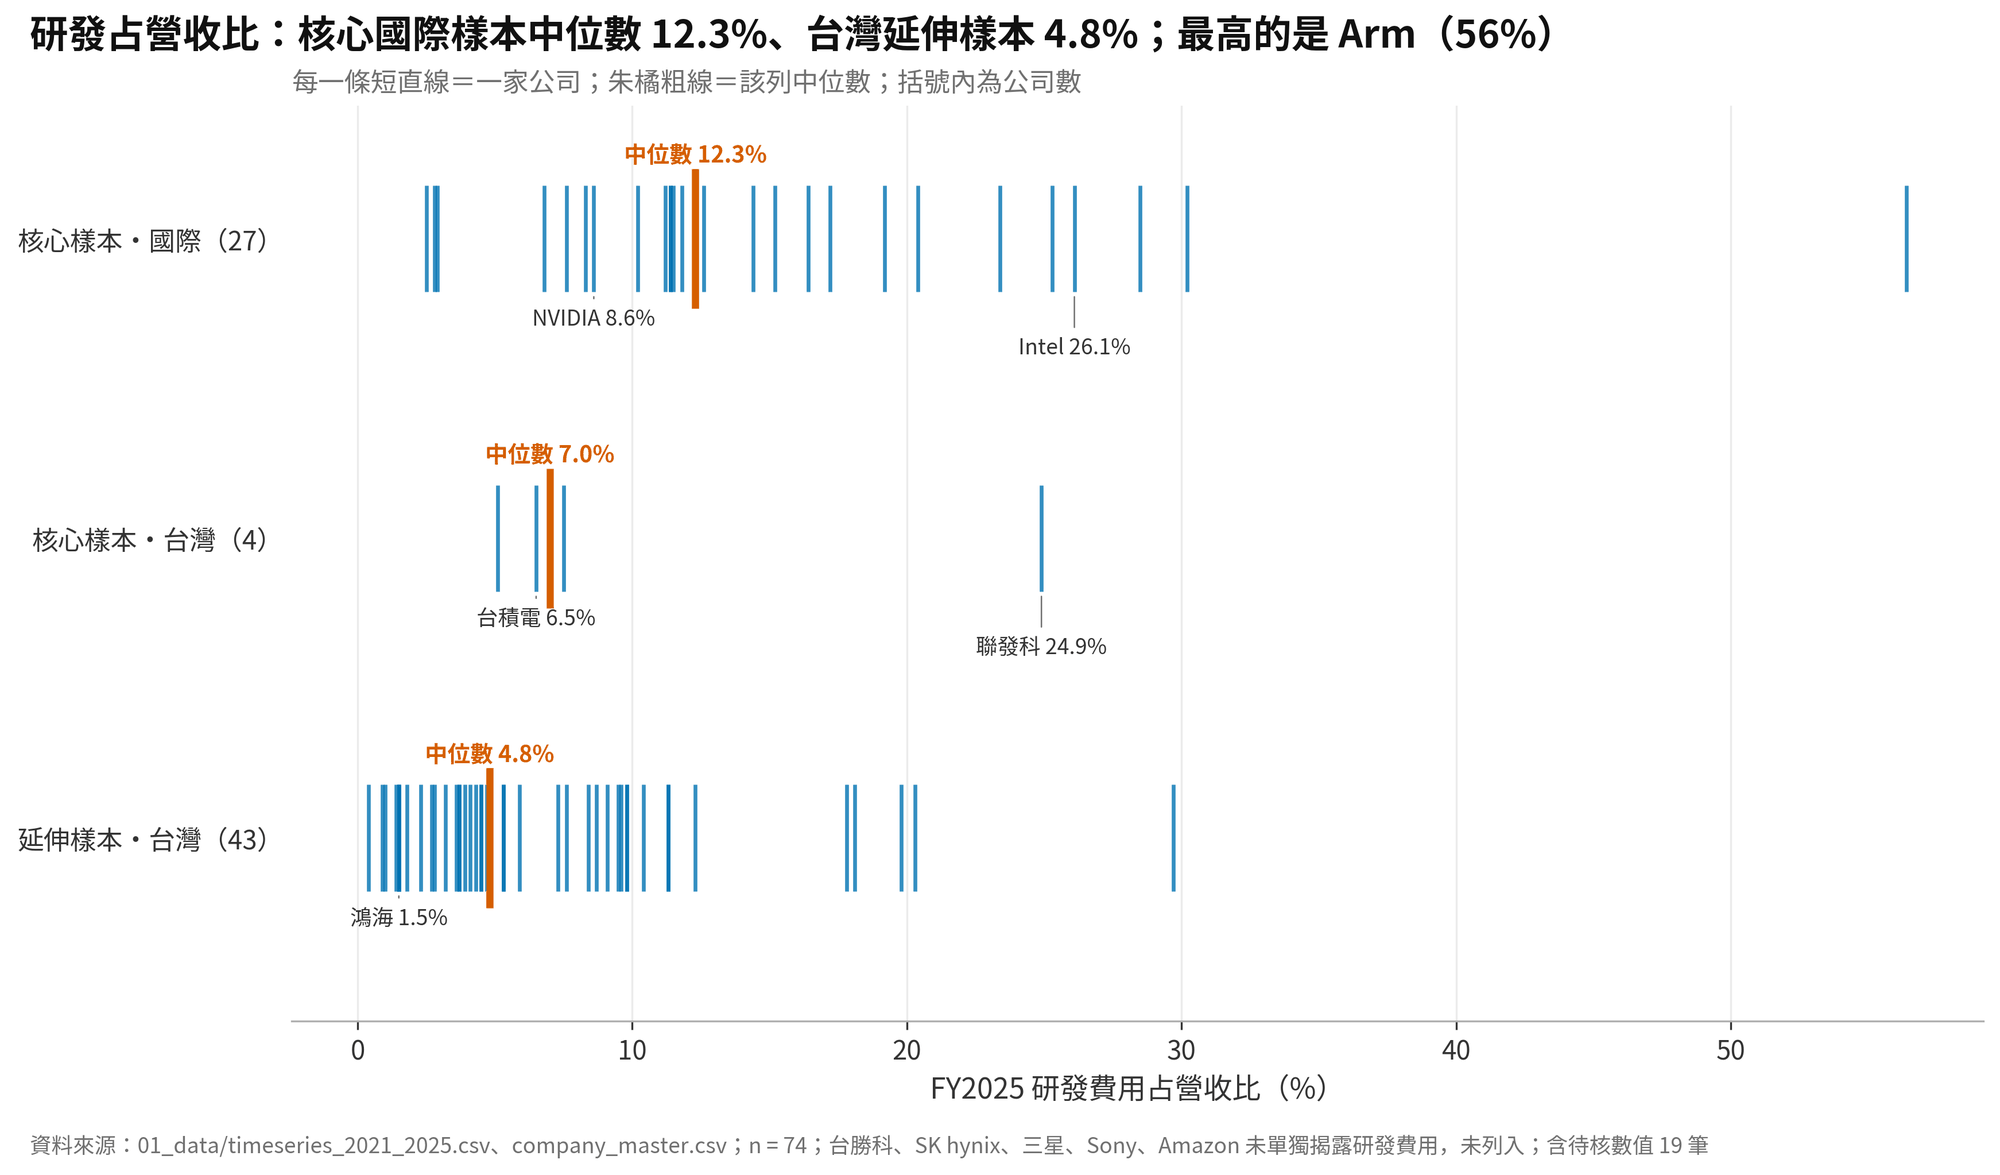
每家公司只占一條細線,幾十家放在一列也不擠;密集處是多數公司的位置,稀疏處是例外。有幾家公司沒有單獨揭露研發費用,例如三星、SK hynix、Amazon,這裡不補 0、直接排除;補 0 會把它們誤畫成「不做研發」。條碼圖的缺點是數值接近的公司會疊成一條線,看不出有幾家;研發費用的認列方式(資本化或費用化)也會影響比率的高低。
八、累積曲線:集中度有多高
營收集中在少數公司手上嗎?前 5 大拿走多少?
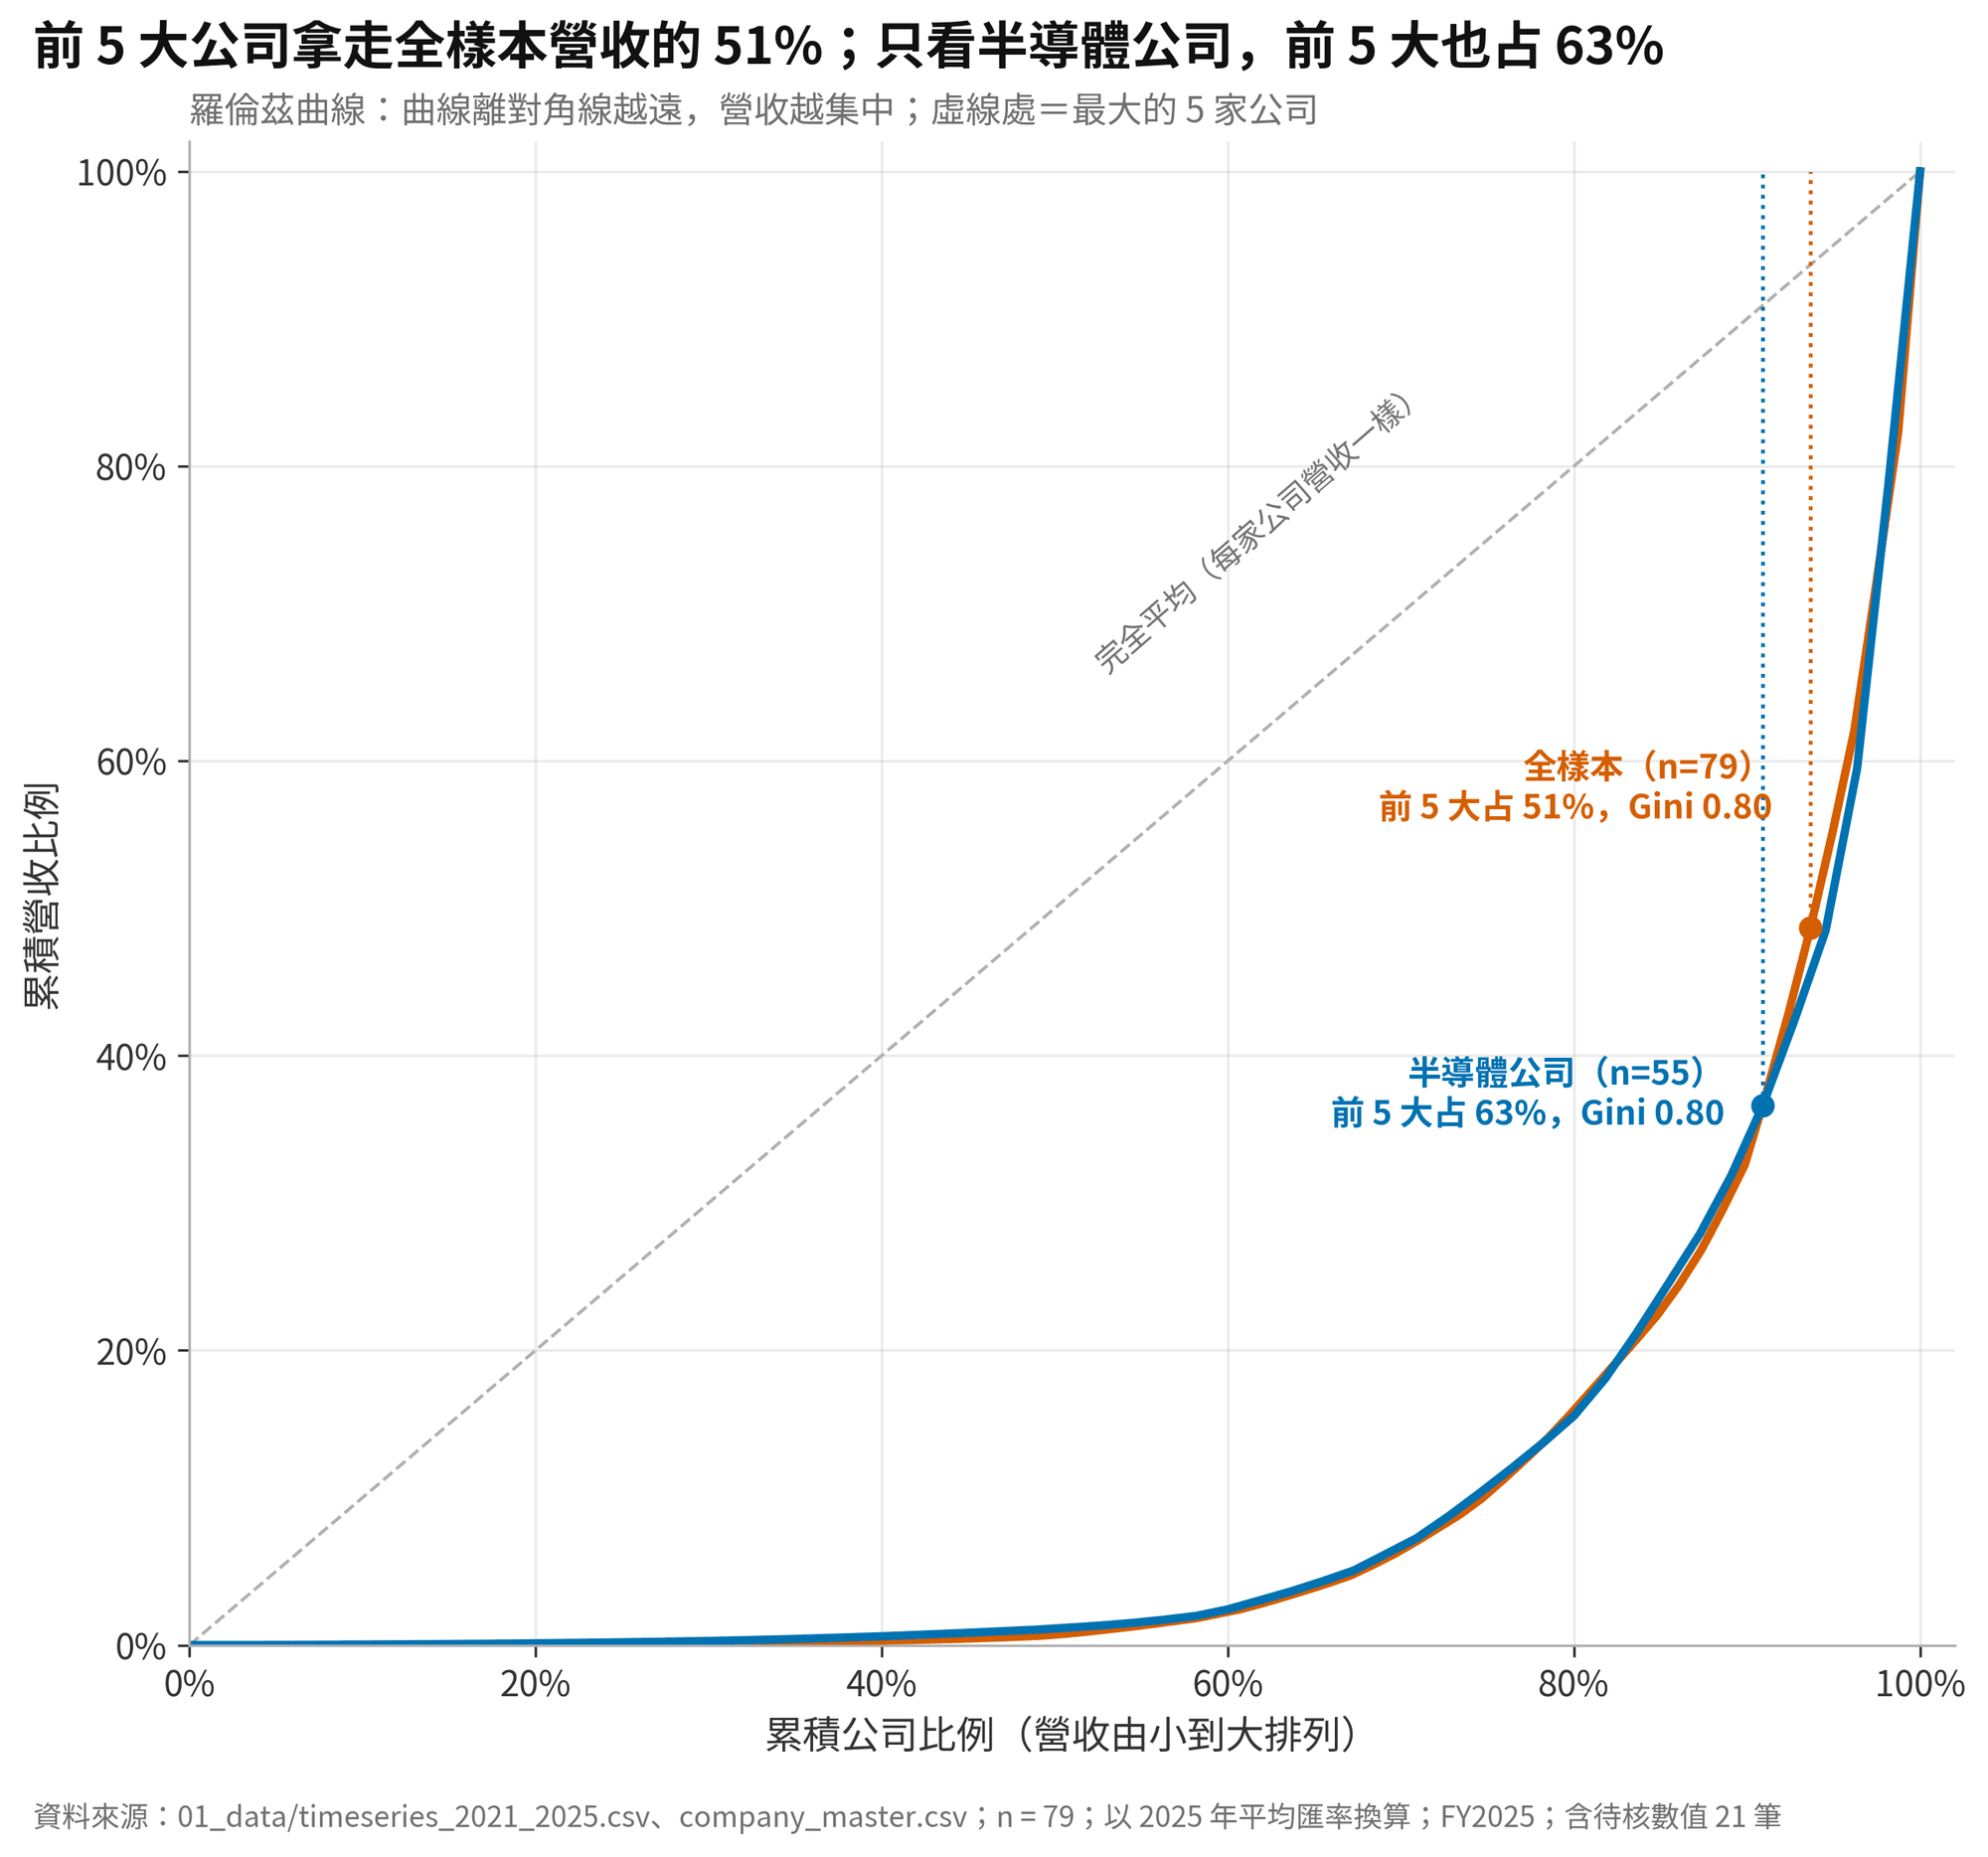
這裡用的是經濟學最熟悉的累積曲線:羅倫茲曲線(Lorenz curve)。全樣本的前 5 大是 Amazon、Apple、Alphabet、Microsoft、鴻海;只看半導體公司,前 5 大是三星、NVIDIA、台積電、SK hynix、Broadcom,兩組的吉尼係數(Gini)都是 0.80。吉尼係數等於 0 代表每家公司一樣大,越接近 1 越集中。
但這是「研究樣本內」的集中度,不是全球產業的市占集中度;樣本裡放進越多小公司,吉尼係數就會越高。營收也會重複計算:台積電的營收,有一部分就是 NVIDIA、Apple 的成本。
九、頻率多邊圖:把幾個分布疊在一起
記憶體公司、台積電、聯發科與鴻海的月營收年增率,分布形狀有什麼不同?
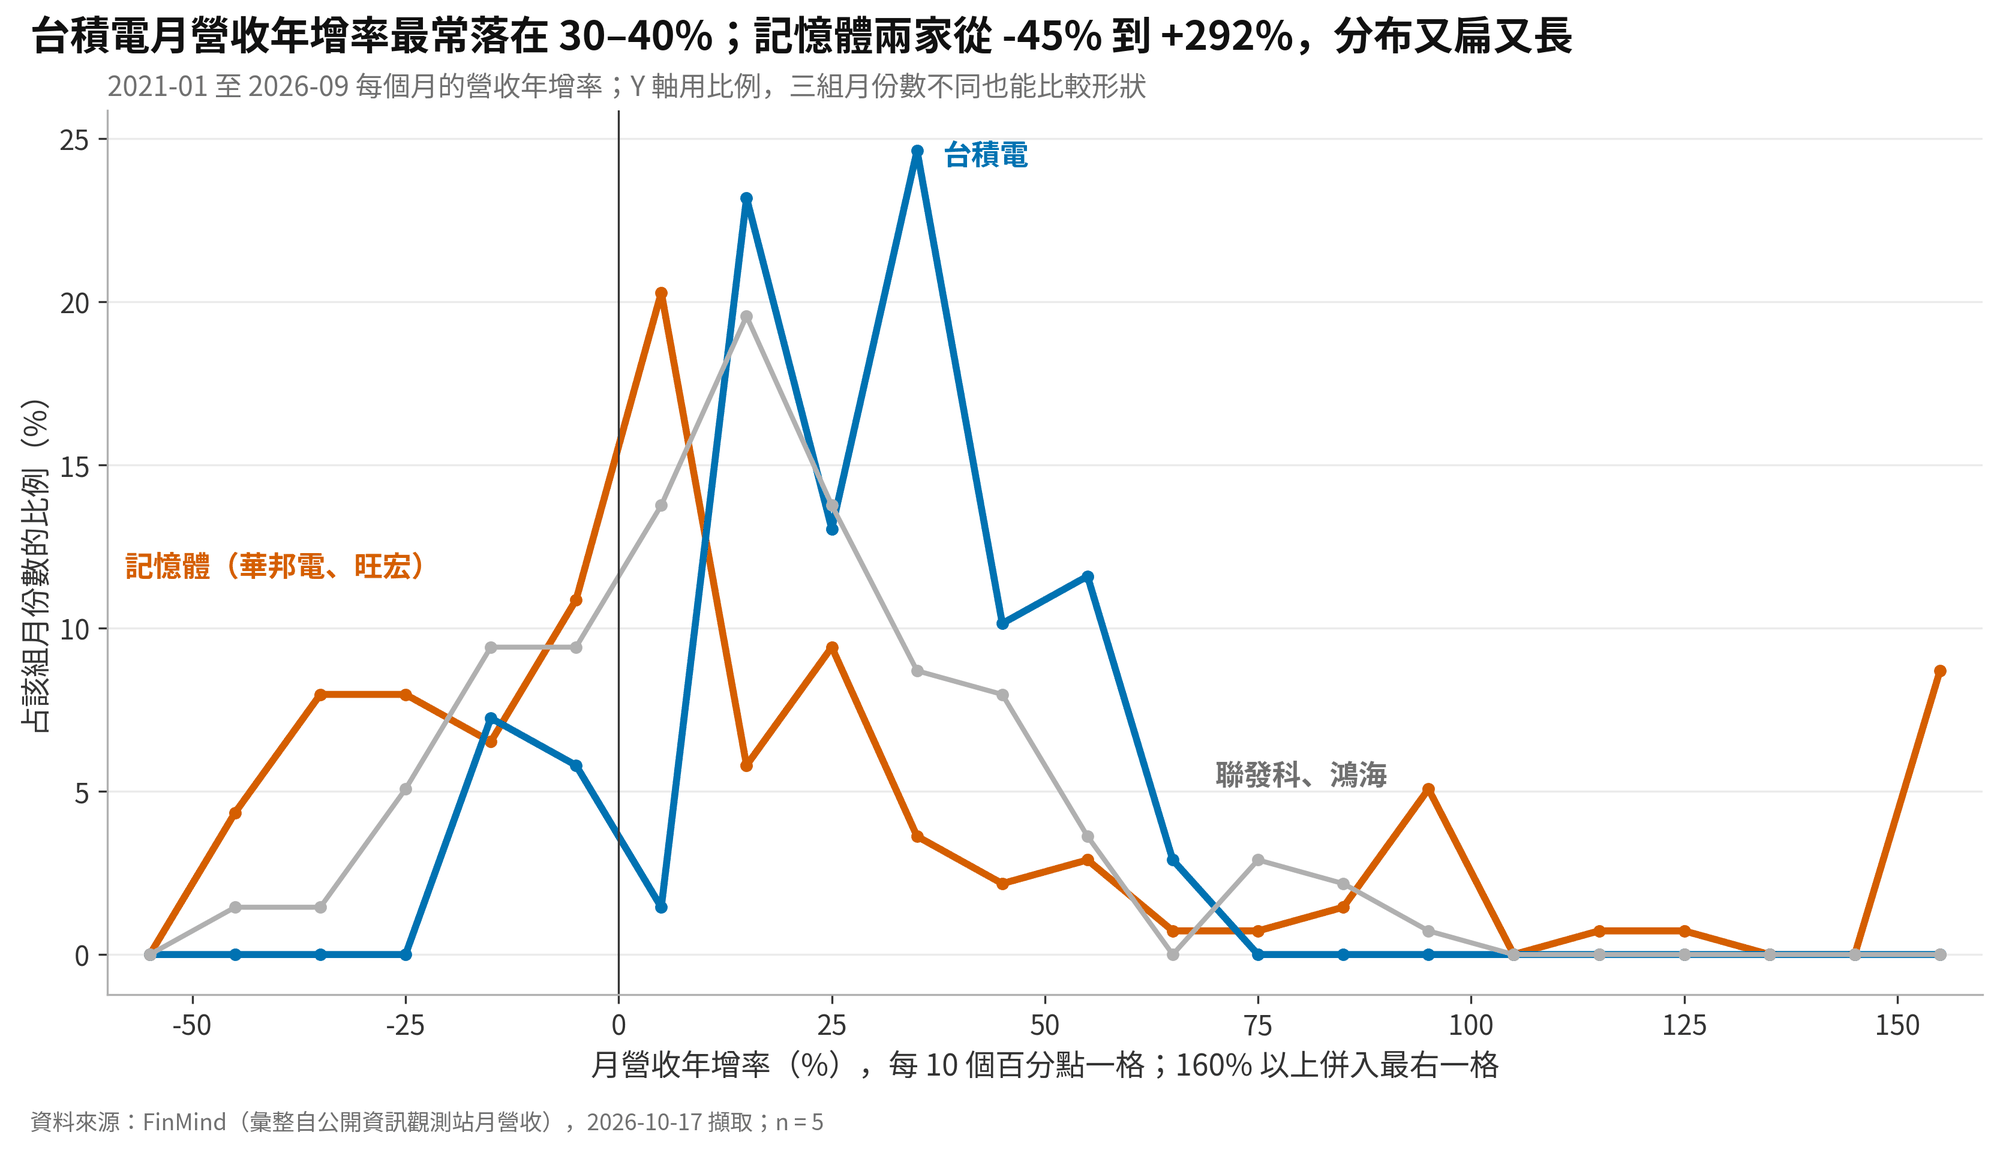
三個直方圖疊在一起會互相遮住,把每個直方圖的柱頂連成折線,三組就能放在同一張圖比較形狀。台積電月營收年增率的標準差是 21 個百分點,記憶體公司是 68 個百分點;不看時間順序、只看形狀,就能看出誰的營收像坐雲霄飛車。
這張圖的陷阱是:組距與上下限都是作者選的;把兩家公司合成一組,會把兩家各自的形狀混在一起;連續月份的年增率高度相關,不能當成獨立樣本去做統計檢定。
十、為什麼「平均」這麼好用,又這麼危險
平均數是一種社會契約:大家同意用一個數字代表一群人,因為它好記、好比較、好寫進新聞標題。「平均薪資」「平均房價」「平均淨利率」,都是這樣被使用的。
問題是,平均數只在分布對稱、單峰的時候才是好代表。偏右的分布(例如所得、公司規模、淨利率)裡,少數極端值會把平均數往上拉,讓大多數人「低於平均」。這也是為什麼主計總處公布薪資時,會同時公布中位數:在一個長尾的世界裡,中位數比平均數更接近「一般人」的處境。
而分布圖的價值,在於它拒絕這種壓縮:它讓讀者看見那些被平均掉的人,也看見平均數本身是怎麼被少數人決定的。
結語:三件事
平均數背後一定有分布。 先畫直方圖或點狀圖,再決定要不要報平均。
分組比較用箱形圖或點狀條紋圖。 不要只畫平均的長條圖。
組距是作者選的。 換一個組距,分布的形狀可能就變了。
下一篇,D07 談隨時間變化:同一段歷史,從哪一年開始畫,就是一個不同的故事。
資料來源與說明
圖型分類與定義:FT Visual Vocabulary(© Financial Times,CC BY-SA 4.0)。
財務數據:91 家半導體產業鏈公司 FY2021–2025 財報,以 2025 年平均匯率換算;權益為負或缺值的公司已排除並註明。
月營收:公開資訊觀測站(經 FinMind 彙整),2026 年 10 月擷取。