

台積電排第幾?排名讓人一眼找到位置,也讓人忘了彼此差多少。

FT Visual Vocabulary 的第三欄是「排序」(Ranking),定義是:當項目在排序中的位置,比它的絕對數值或相對數值更重要時使用。FT 還加了一句很實用的提醒:不要怕強調你關心的那幾個點。FT 常拿它畫財富、貧窮程度、聯賽排名、選區選舉結果。
一、排序長條圖:先排好,讀者就不用自己找
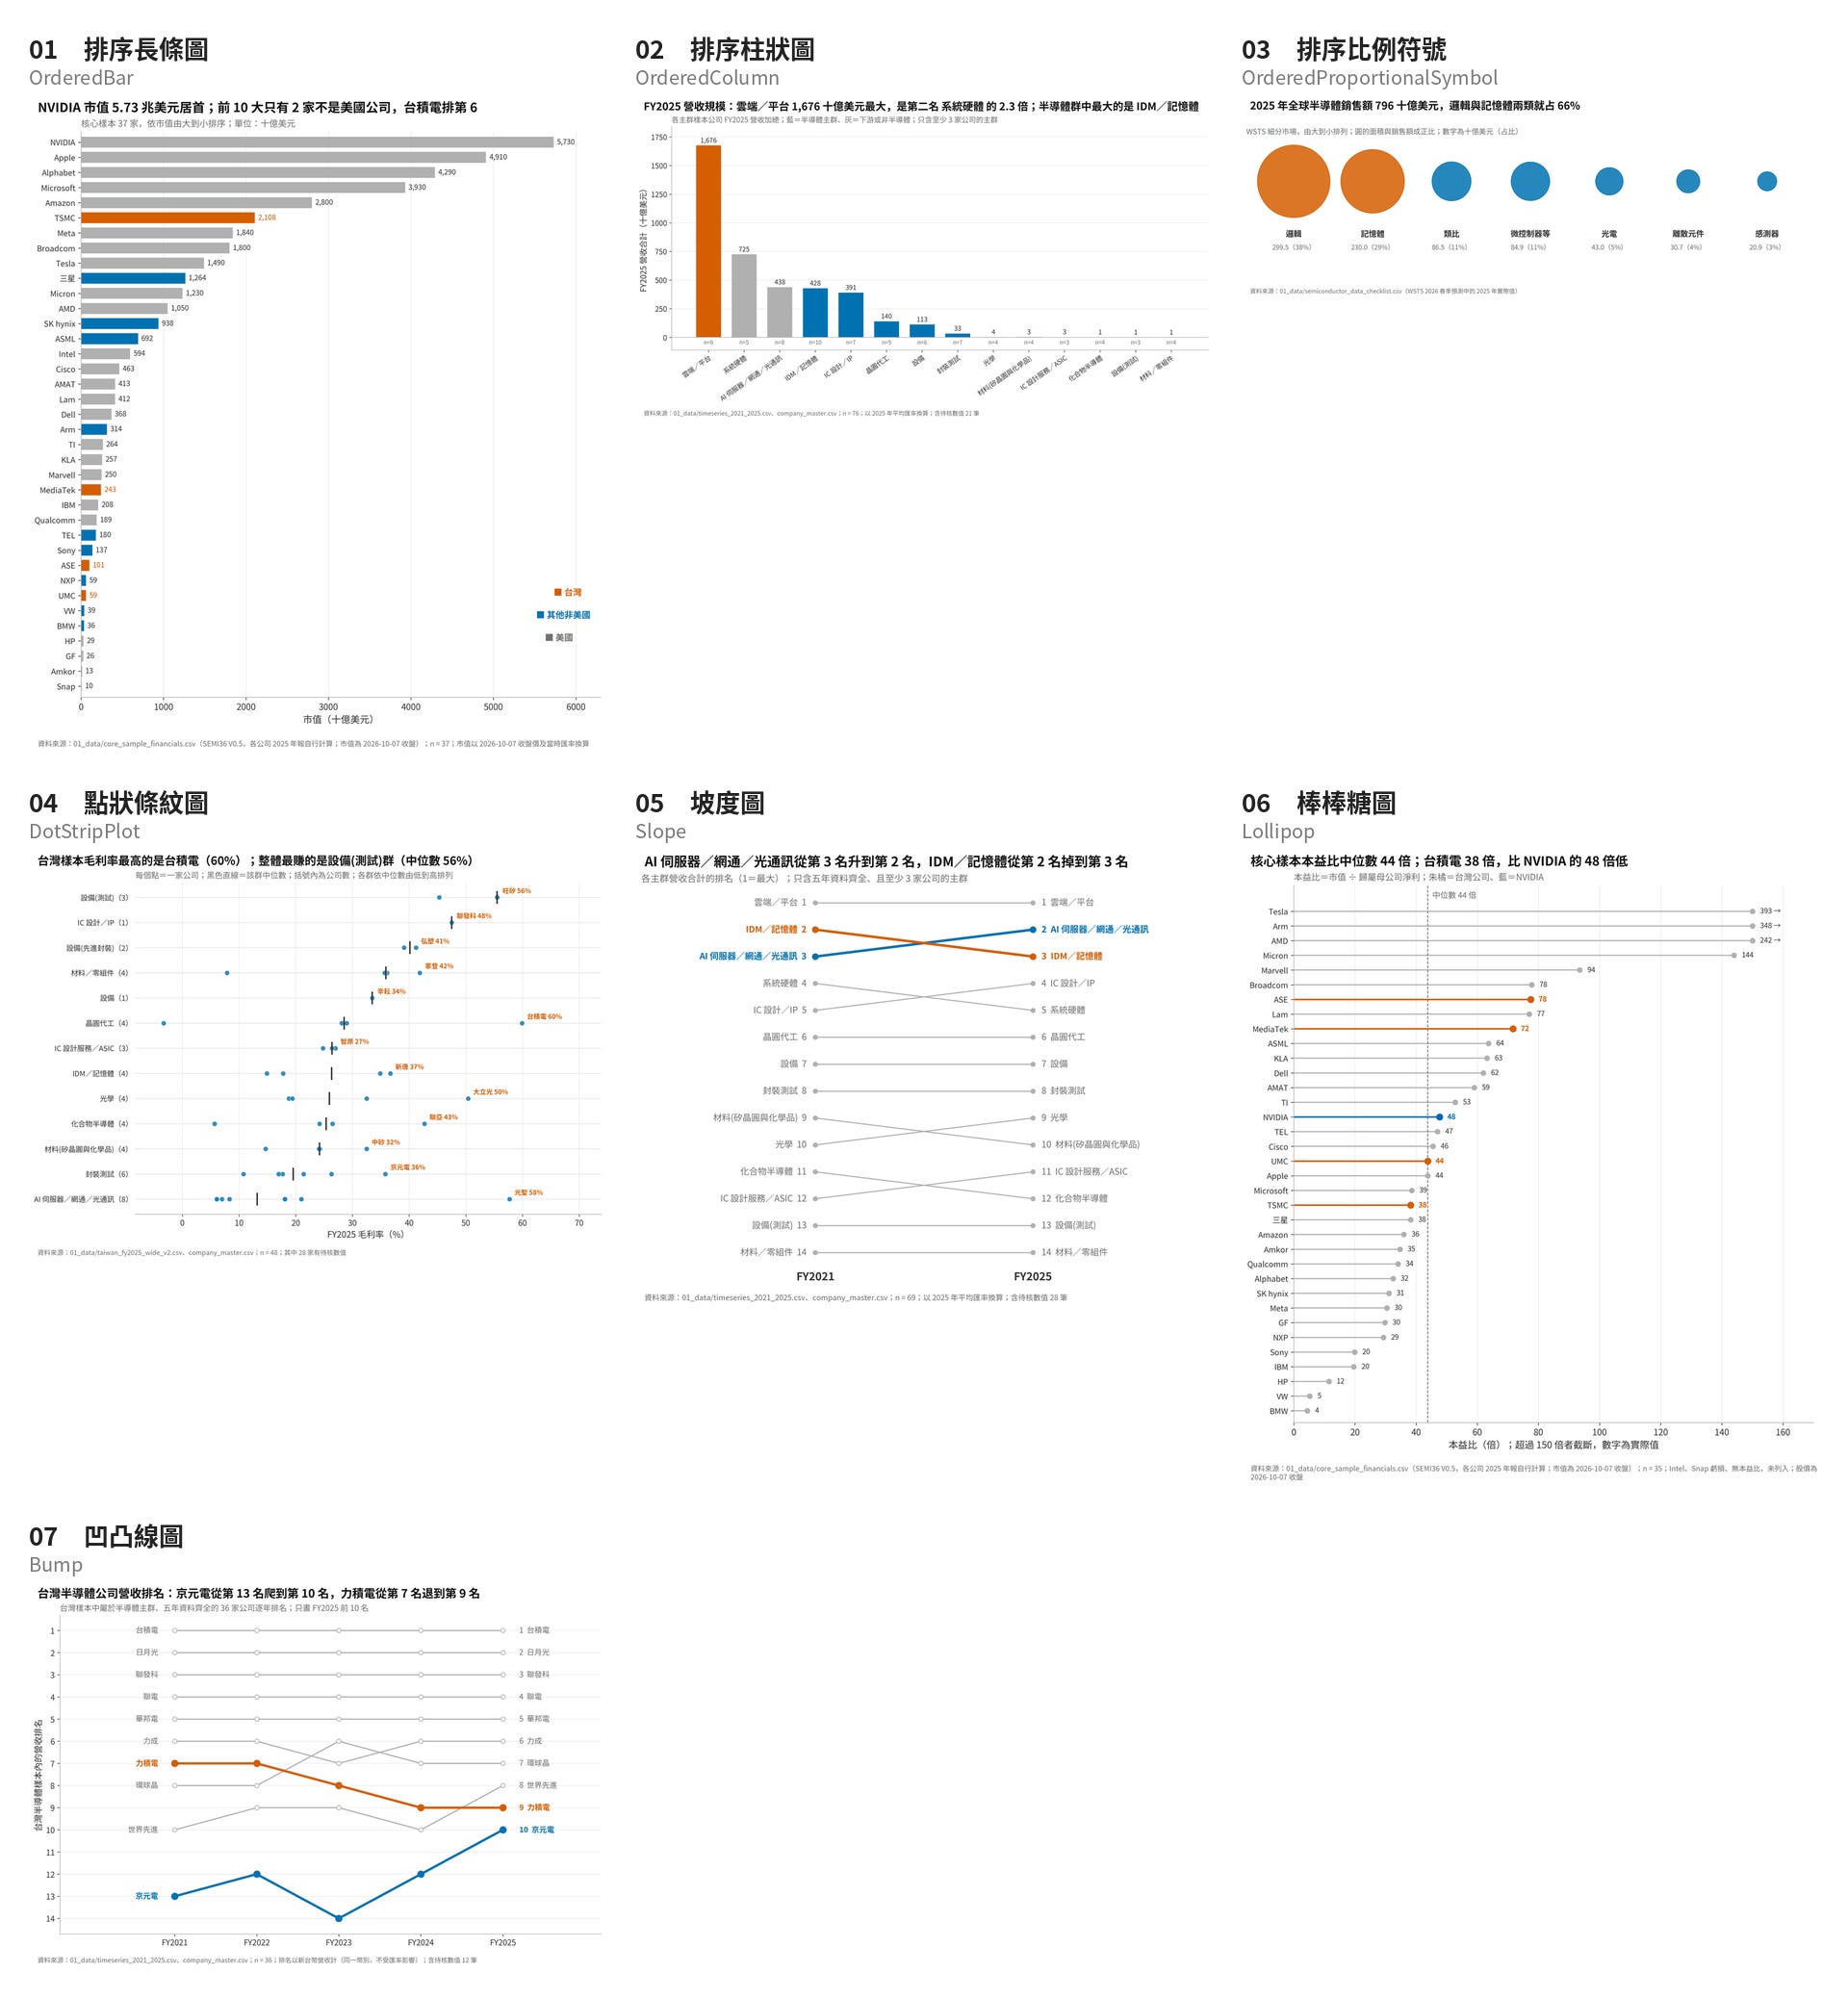
核心樣本裡,誰的市值最大?台灣公司排在哪裡?
類別多(37 家)、名稱長的時候,橫條比直柱好讀;先排序,讀者不用自己找誰第一。台灣的 4 家公司中,台積電排第 6、聯發科第 24、日月光第 29、聯電第 31。顏色只分三類(台灣、其他非美國、美國),國家是這張圖的第二個訊息。
三個陷阱都和「這份名單」有關。市值是時點值:這是 2026 年 10 月 7 日單日收盤的快照,股價一動排名就變,所以圖註一定要寫日期。匯率:非美元公司的市值以當日匯率換算,和其他圖使用的 2025 年平均匯率不同,不要混在同一張圖比較。樣本是挑過的:核心樣本包含 Apple、Amazon 等非半導體公司,「前 10 大」是這份樣本的前 10 大,不是全球的前 10 大。
二、排序柱狀圖:第一名、斷層、長尾
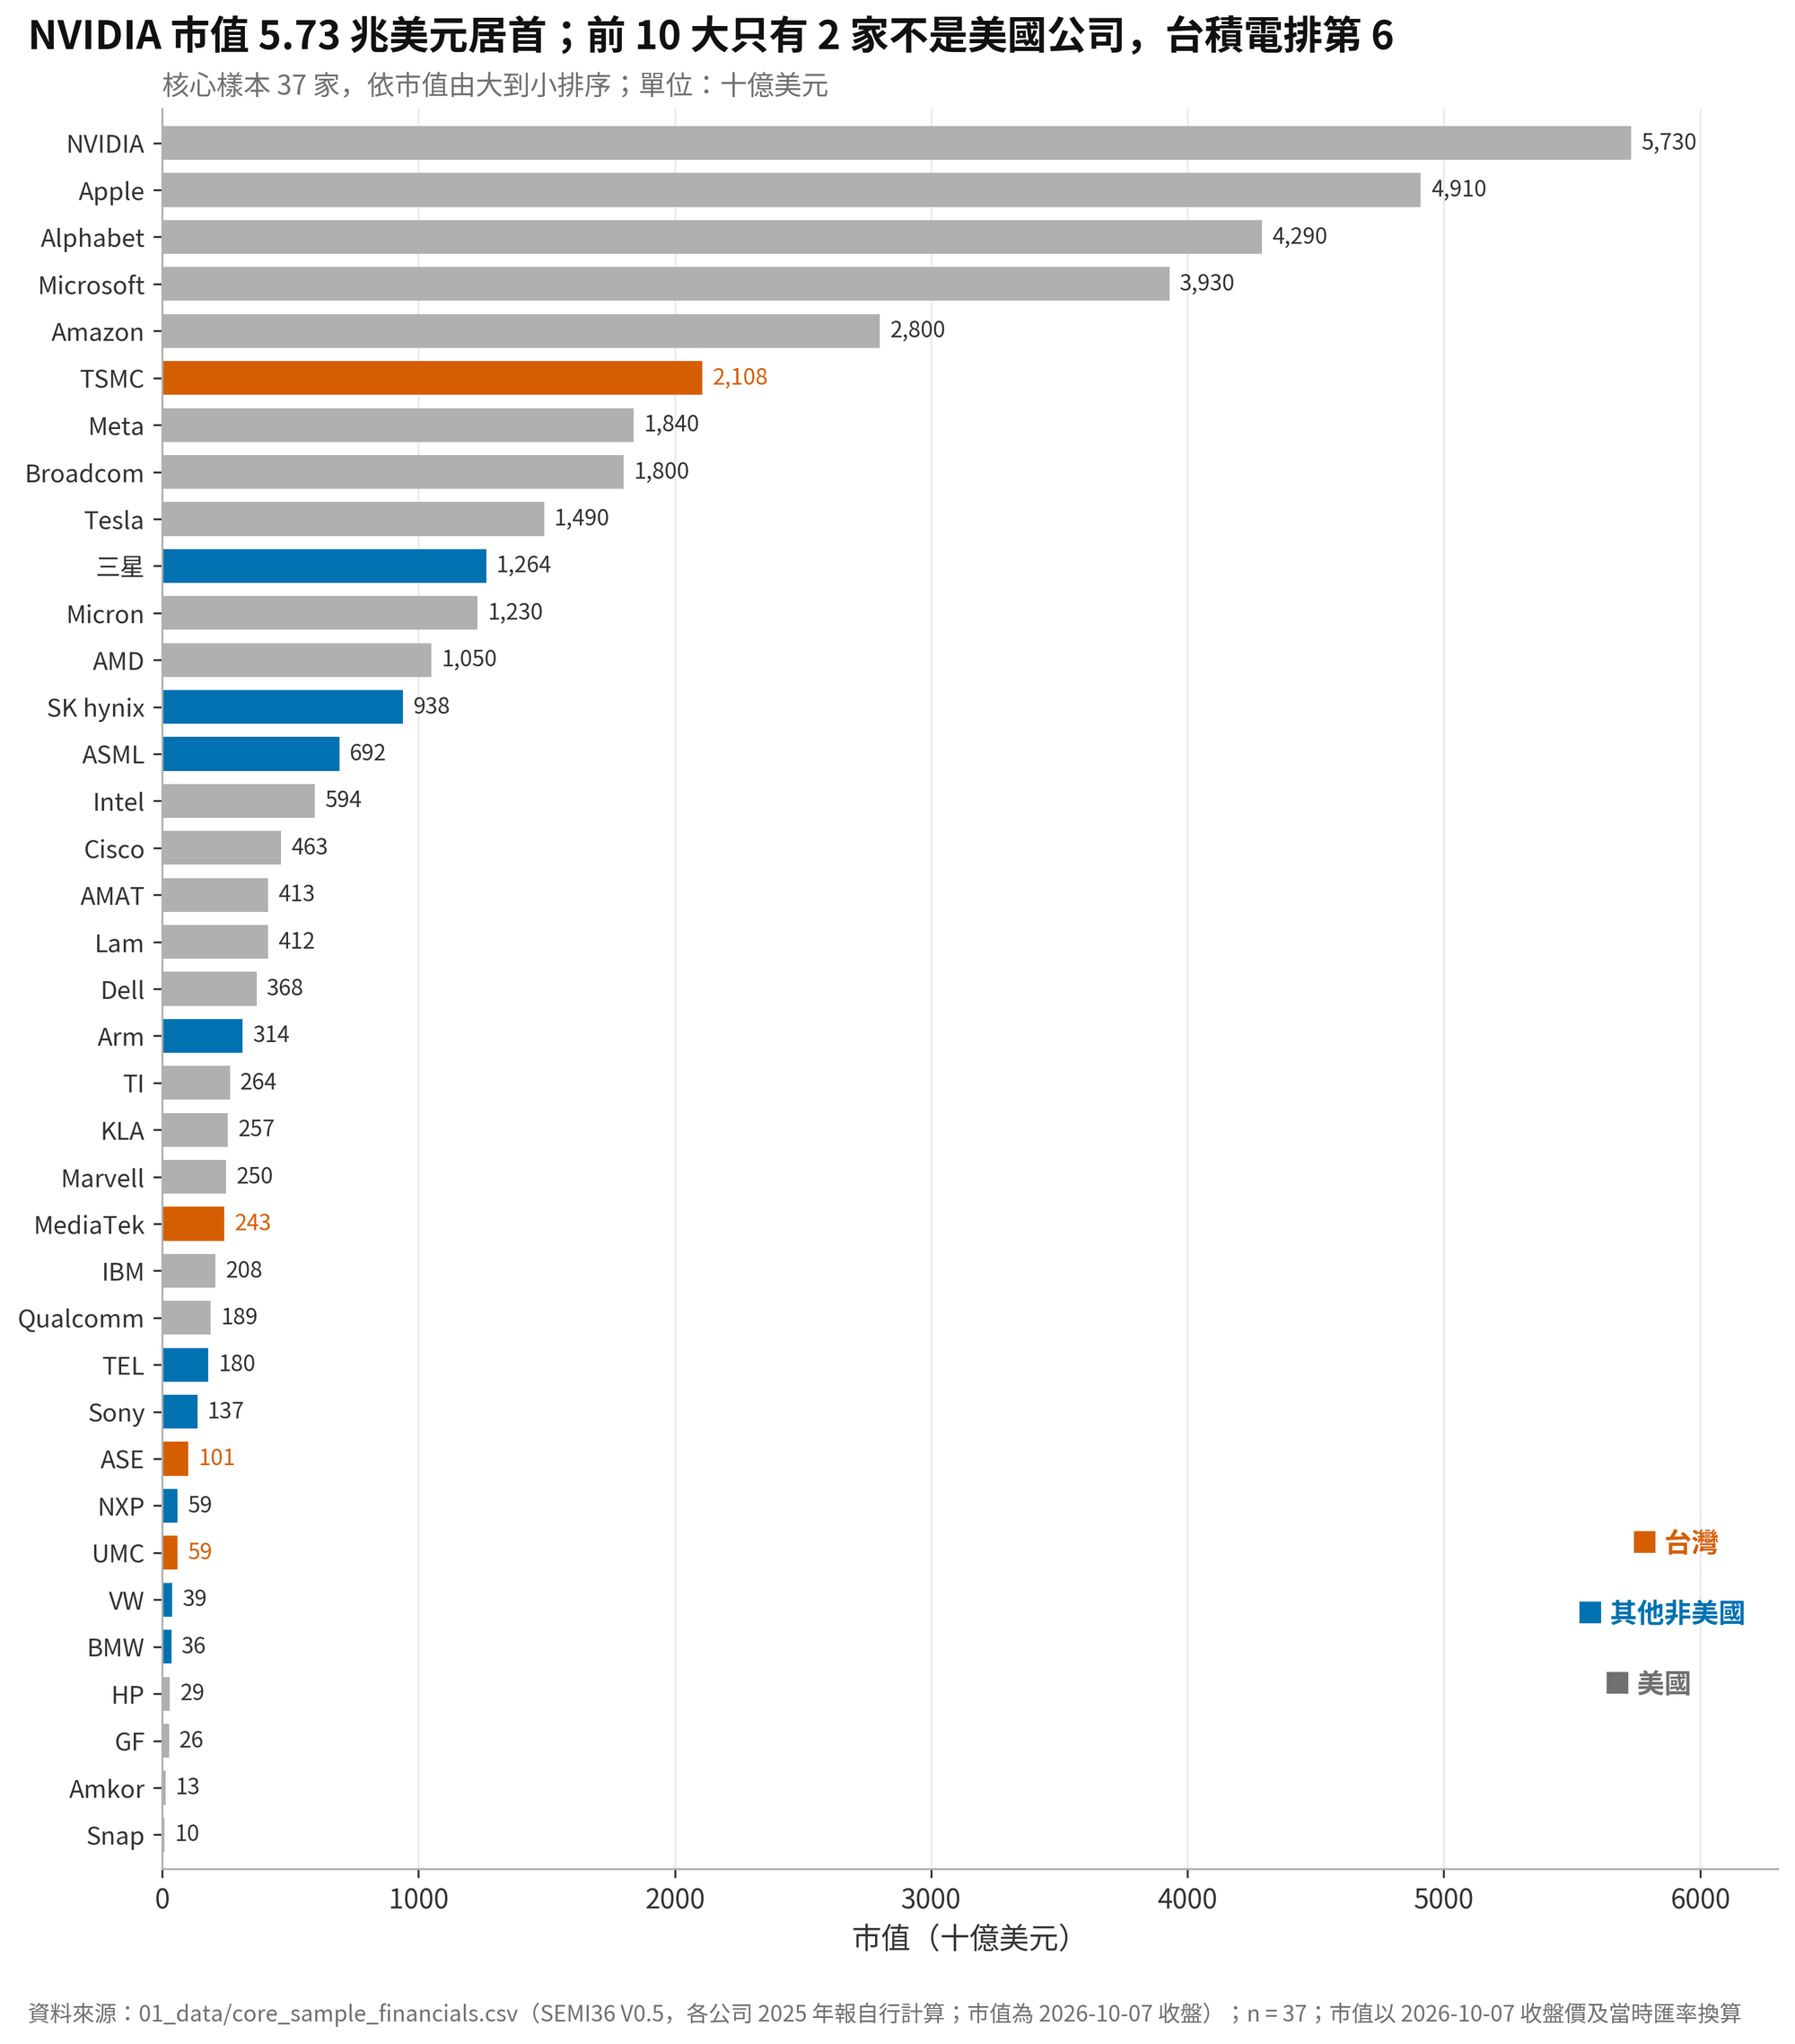
FY2025 各產業群的營收規模,誰最大?
類別不多(14 群)時,由大到小排好的柱狀圖,第一名、斷層、長尾一眼可見。藍色是半導體群,灰色是下游的雲端、系統硬體、AI 伺服器;有點諷刺的是,在這份「半導體」樣本裡,營收最大的反而不是半導體。
這張圖的陷阱在加總。一群放進幾家公司是作者決定的,多放一家就多一截,所以它排的是「樣本內」的規模,不是產業的真實規模。另外還有重複計算的問題:鴻海的營收裡,有一部分就是向台積電、聯發科買晶片的成本,產業群直接相加,會把產業鏈上同一份價值算好幾次。
三、排序比例符號:差距大到長條畫不下
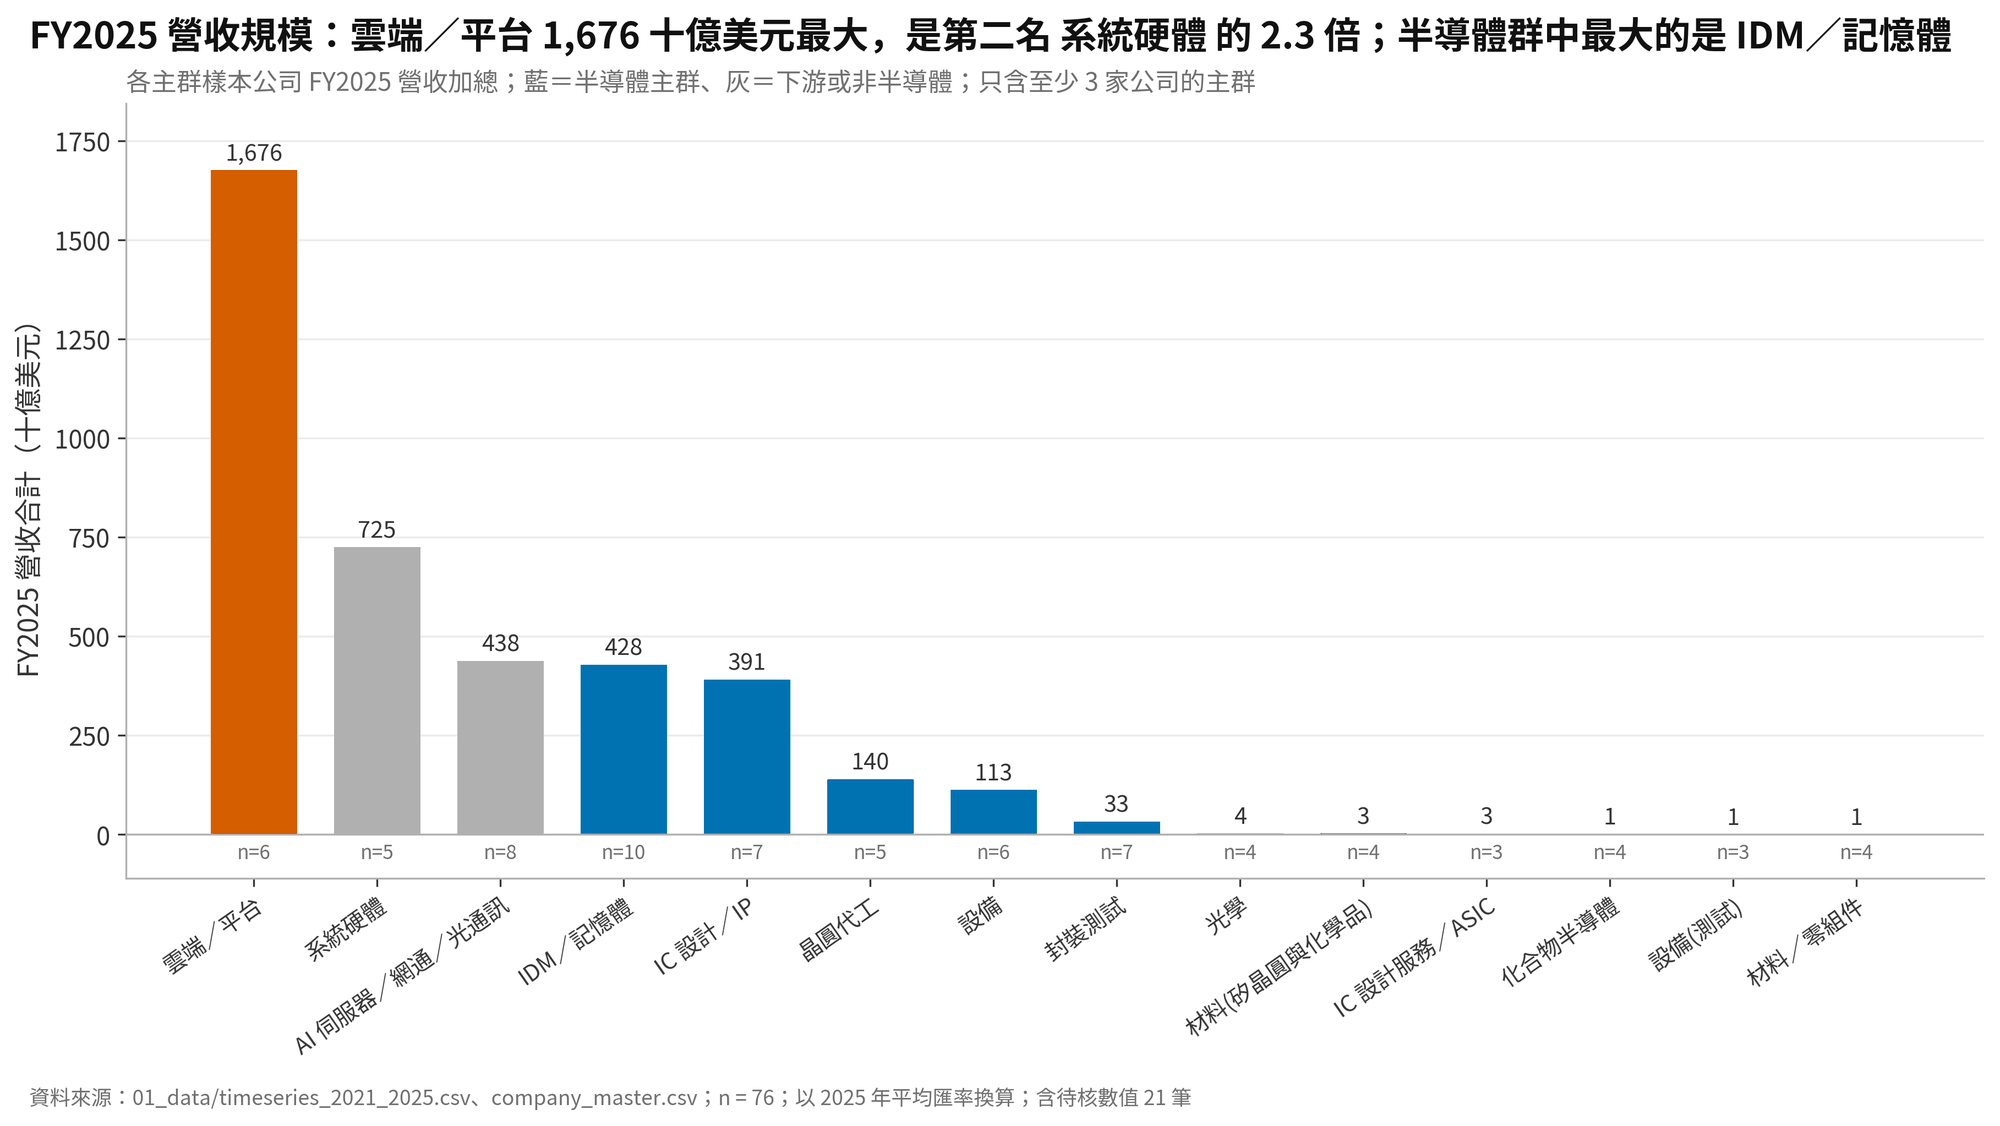
2025 年全球半導體銷售額,各產品類別差多少?
FT 說比例符號適合「展示有巨大差異的數值,或者無需表現數據之間的細微差異時」。最大的邏輯晶片(3,000 億美元)和最小的感測器(210 億美元)差了 14 倍,用長條圖的話,小的幾根會短到看不見。圓的面積與數值成正比,所以半徑要取平方根;如果讓半徑與數值成正比,邏輯的圓面積會被誇大成感測器的 205 倍。
但人眼比較面積本來就很不準,圓的大小只看得出「差很多」,看不出「差 20% 還是 30%」,所以每個圓下方都寫上數字。分類的顆粒度也會影響圖的樣子:「邏輯」包含 CPU、GPU、ASIC,「記憶體」包含 DRAM、NAND,分得越粗,越容易出現一兩個大圓。
四、點狀條紋圖:一張圖,兩層排序
台灣樣本各產業群裡,毛利率最高、最低的是誰?哪一群整體最賺?
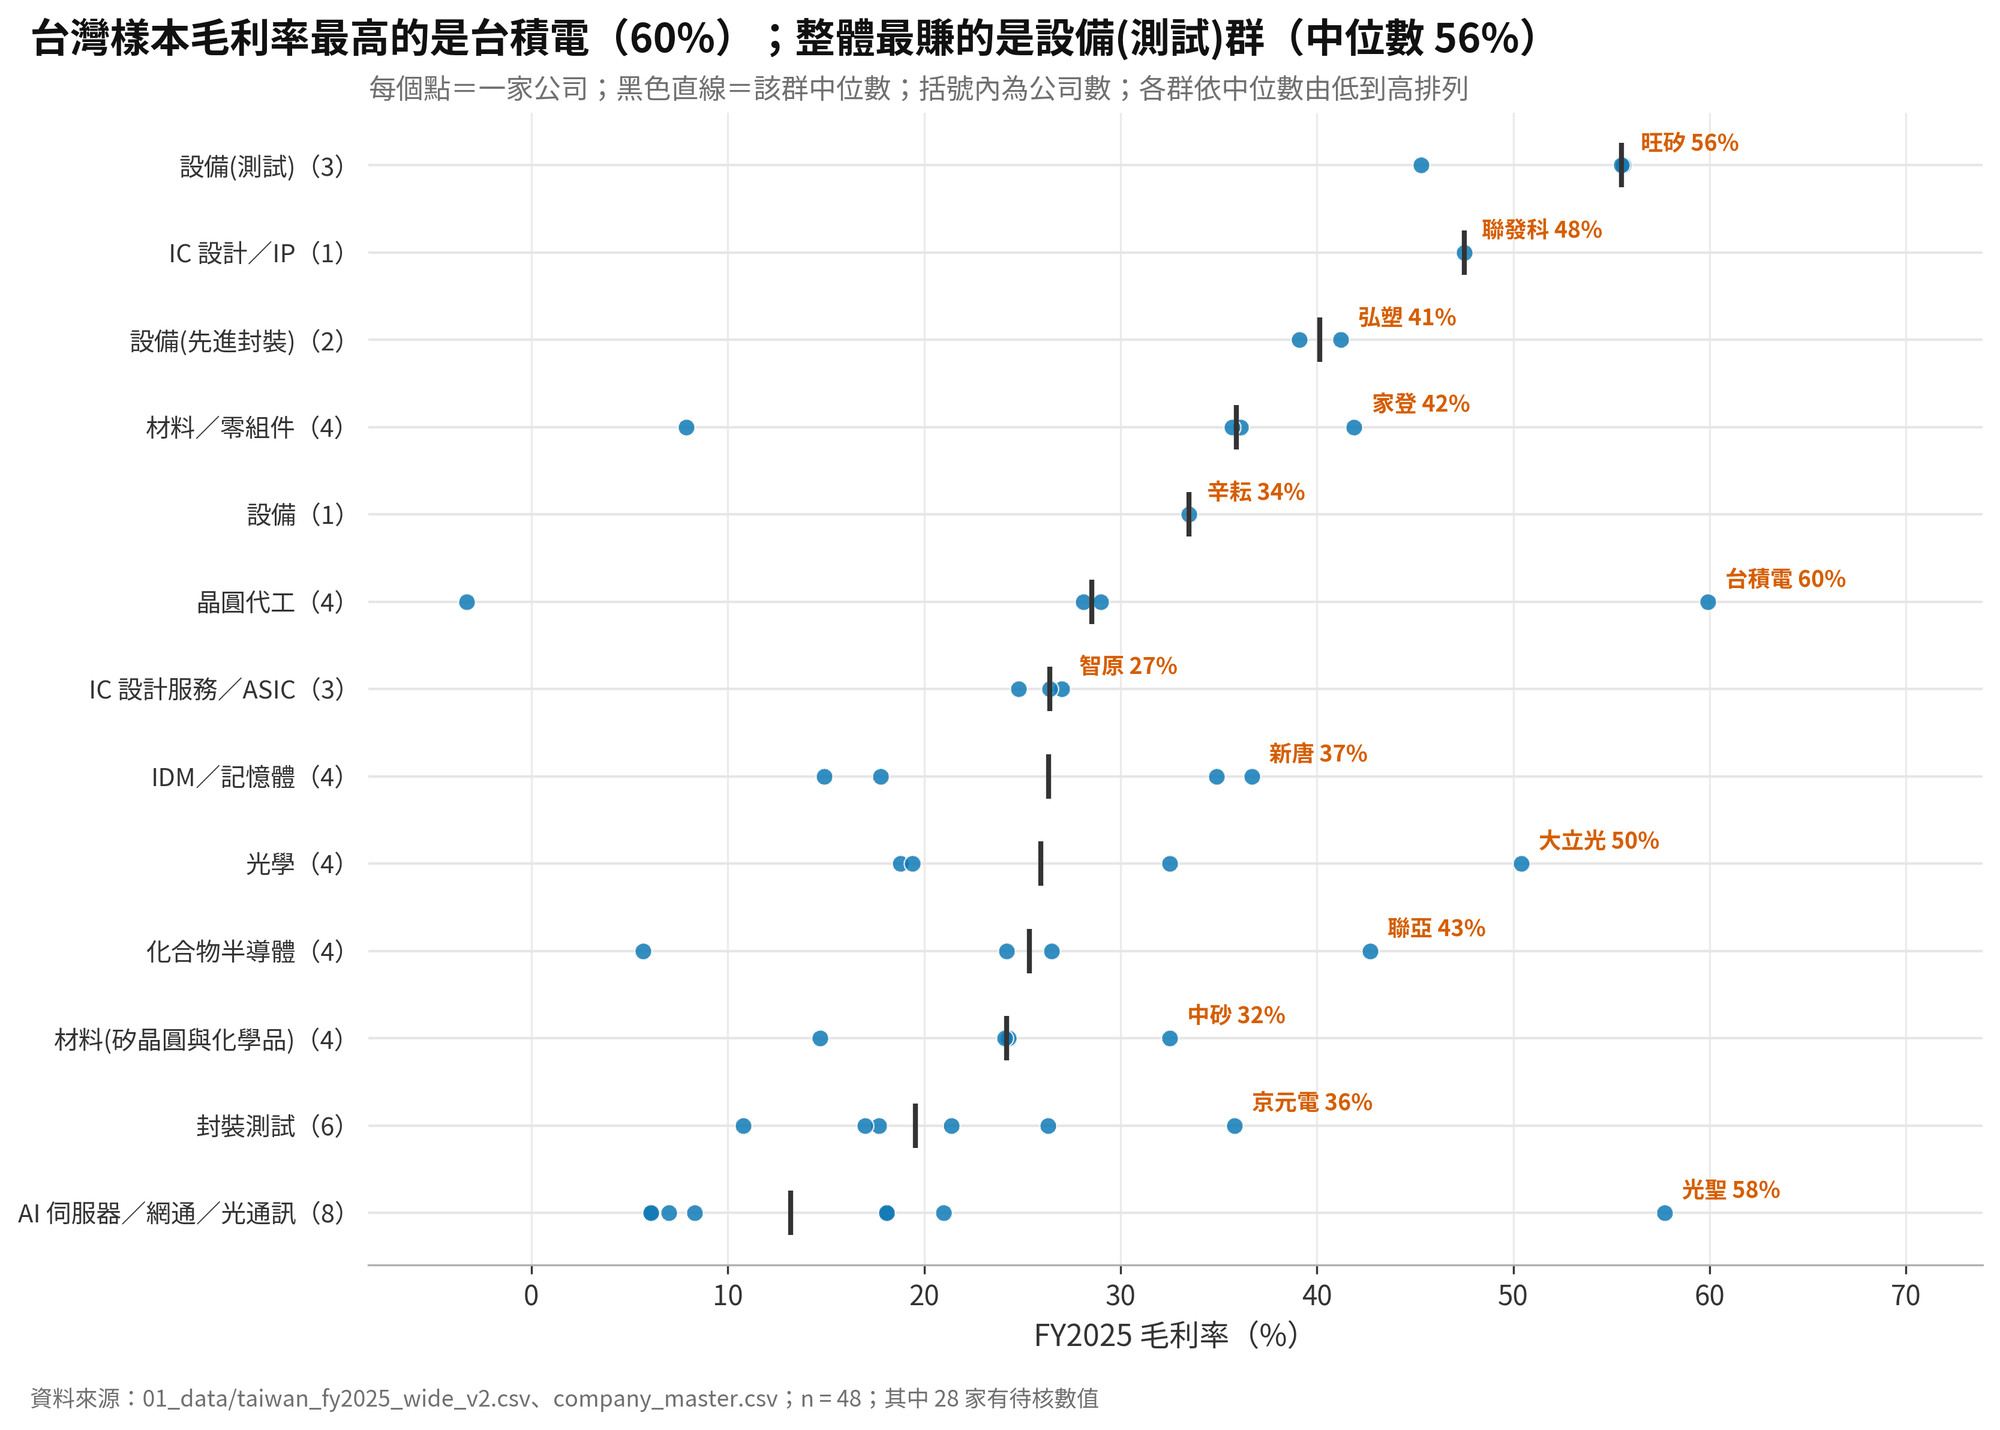
點狀條紋圖一次回答兩個排序問題:群與群之間(列的順序),以及群內公司之間(點的位置)。毛利率中位數最低的是 AI 伺服器、網通與光通訊群(13%),最高的是測試設備群(56%),每一列的橘色標籤是該群的第一名。
陷阱是:有的群只有兩三家公司,中位數就是其中一家,點少的列不要過度解讀;而毛利率的定義也隨產業而異,代工廠的折舊大量計入營業成本,IC 設計公司則沒有晶圓廠,毛利率的高低有一部分反映的是商業模式,不只是競爭力。
五、坡度圖:只畫名次,不畫金額
2021 到 2025 年,各產業群的營收規模排名怎麼變?誰往上爬、誰往下掉?
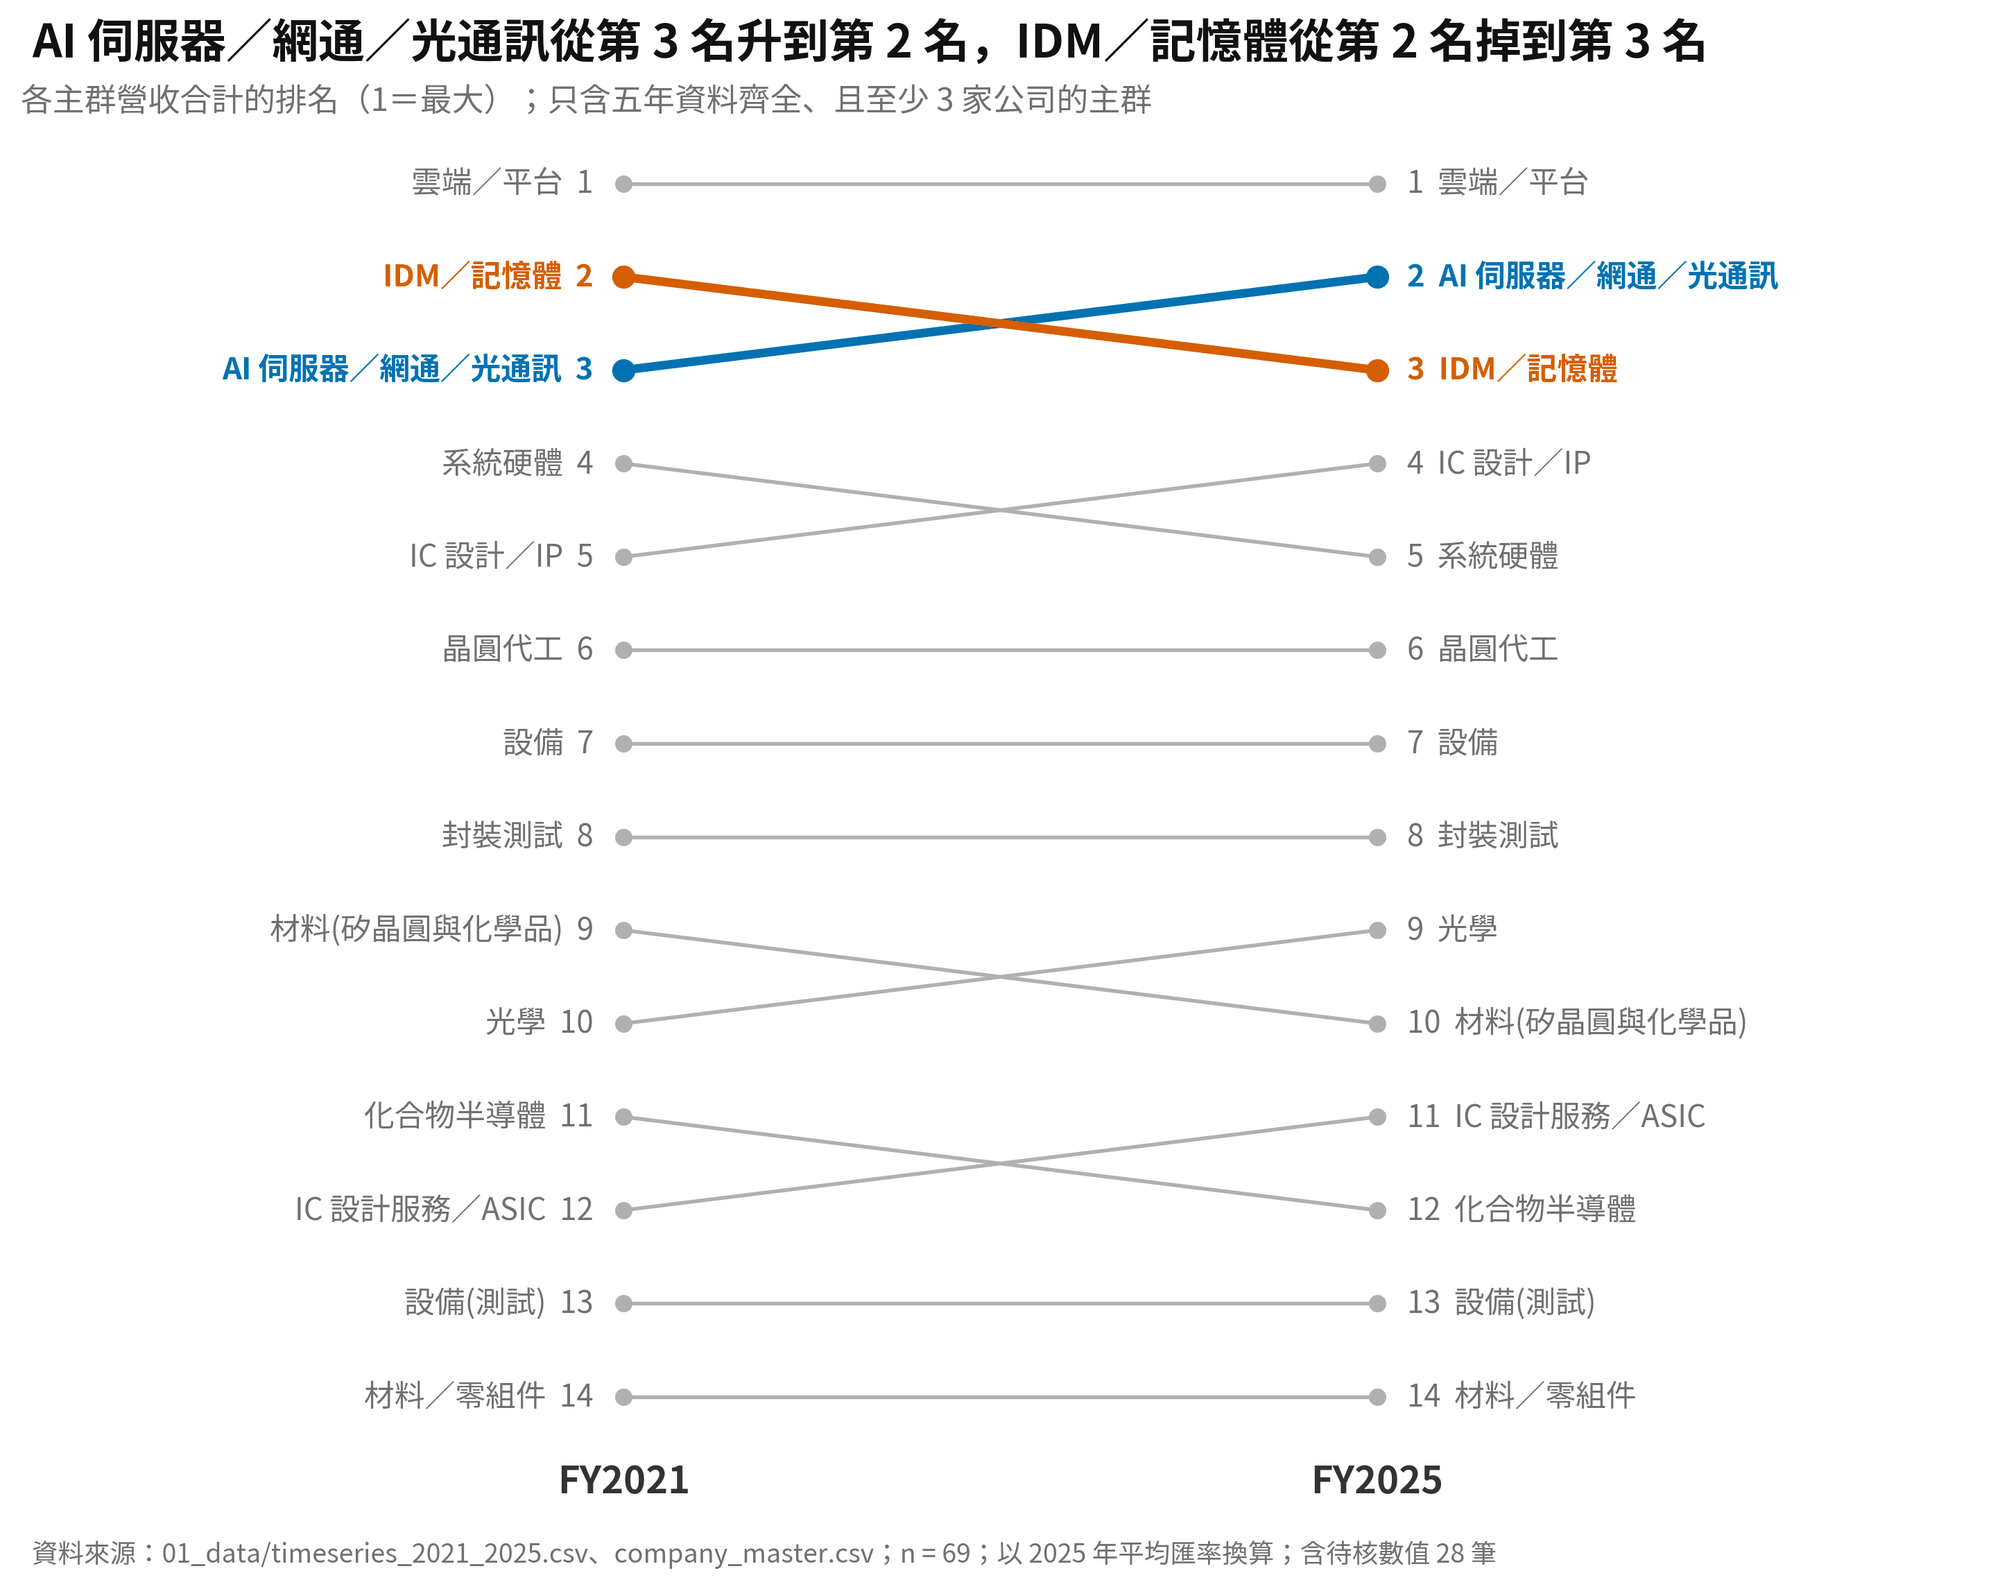
FT 把坡度圖同時放在「排序」與「隨時間變化」兩欄,這一張只畫名次:線交叉就是名次對調,斜率就是爬升或下滑的幅度。AI 伺服器、網通與光通訊群的營收從 2,650 億美元增加到 4,380 億美元,IDM 與記憶體群從 3,420 億美元增加到 3,910 億美元,兩群都在成長,但名次對調了。
排名最大的問題,是丟掉了距離。第 1 名和第 2 名可能差 2 倍,第 10 名和第 11 名可能只差 1%,在排名圖上卻看起來一樣遠;要看距離,還是得回到柱狀圖。名次也會被樣本組成左右,某一群多放一家公司,就可能多爬一名。
六、棒棒糖圖:把注意力放在端點
市場給每家公司多少倍的本益比?台積電和同業比起來,是貴還是便宜?
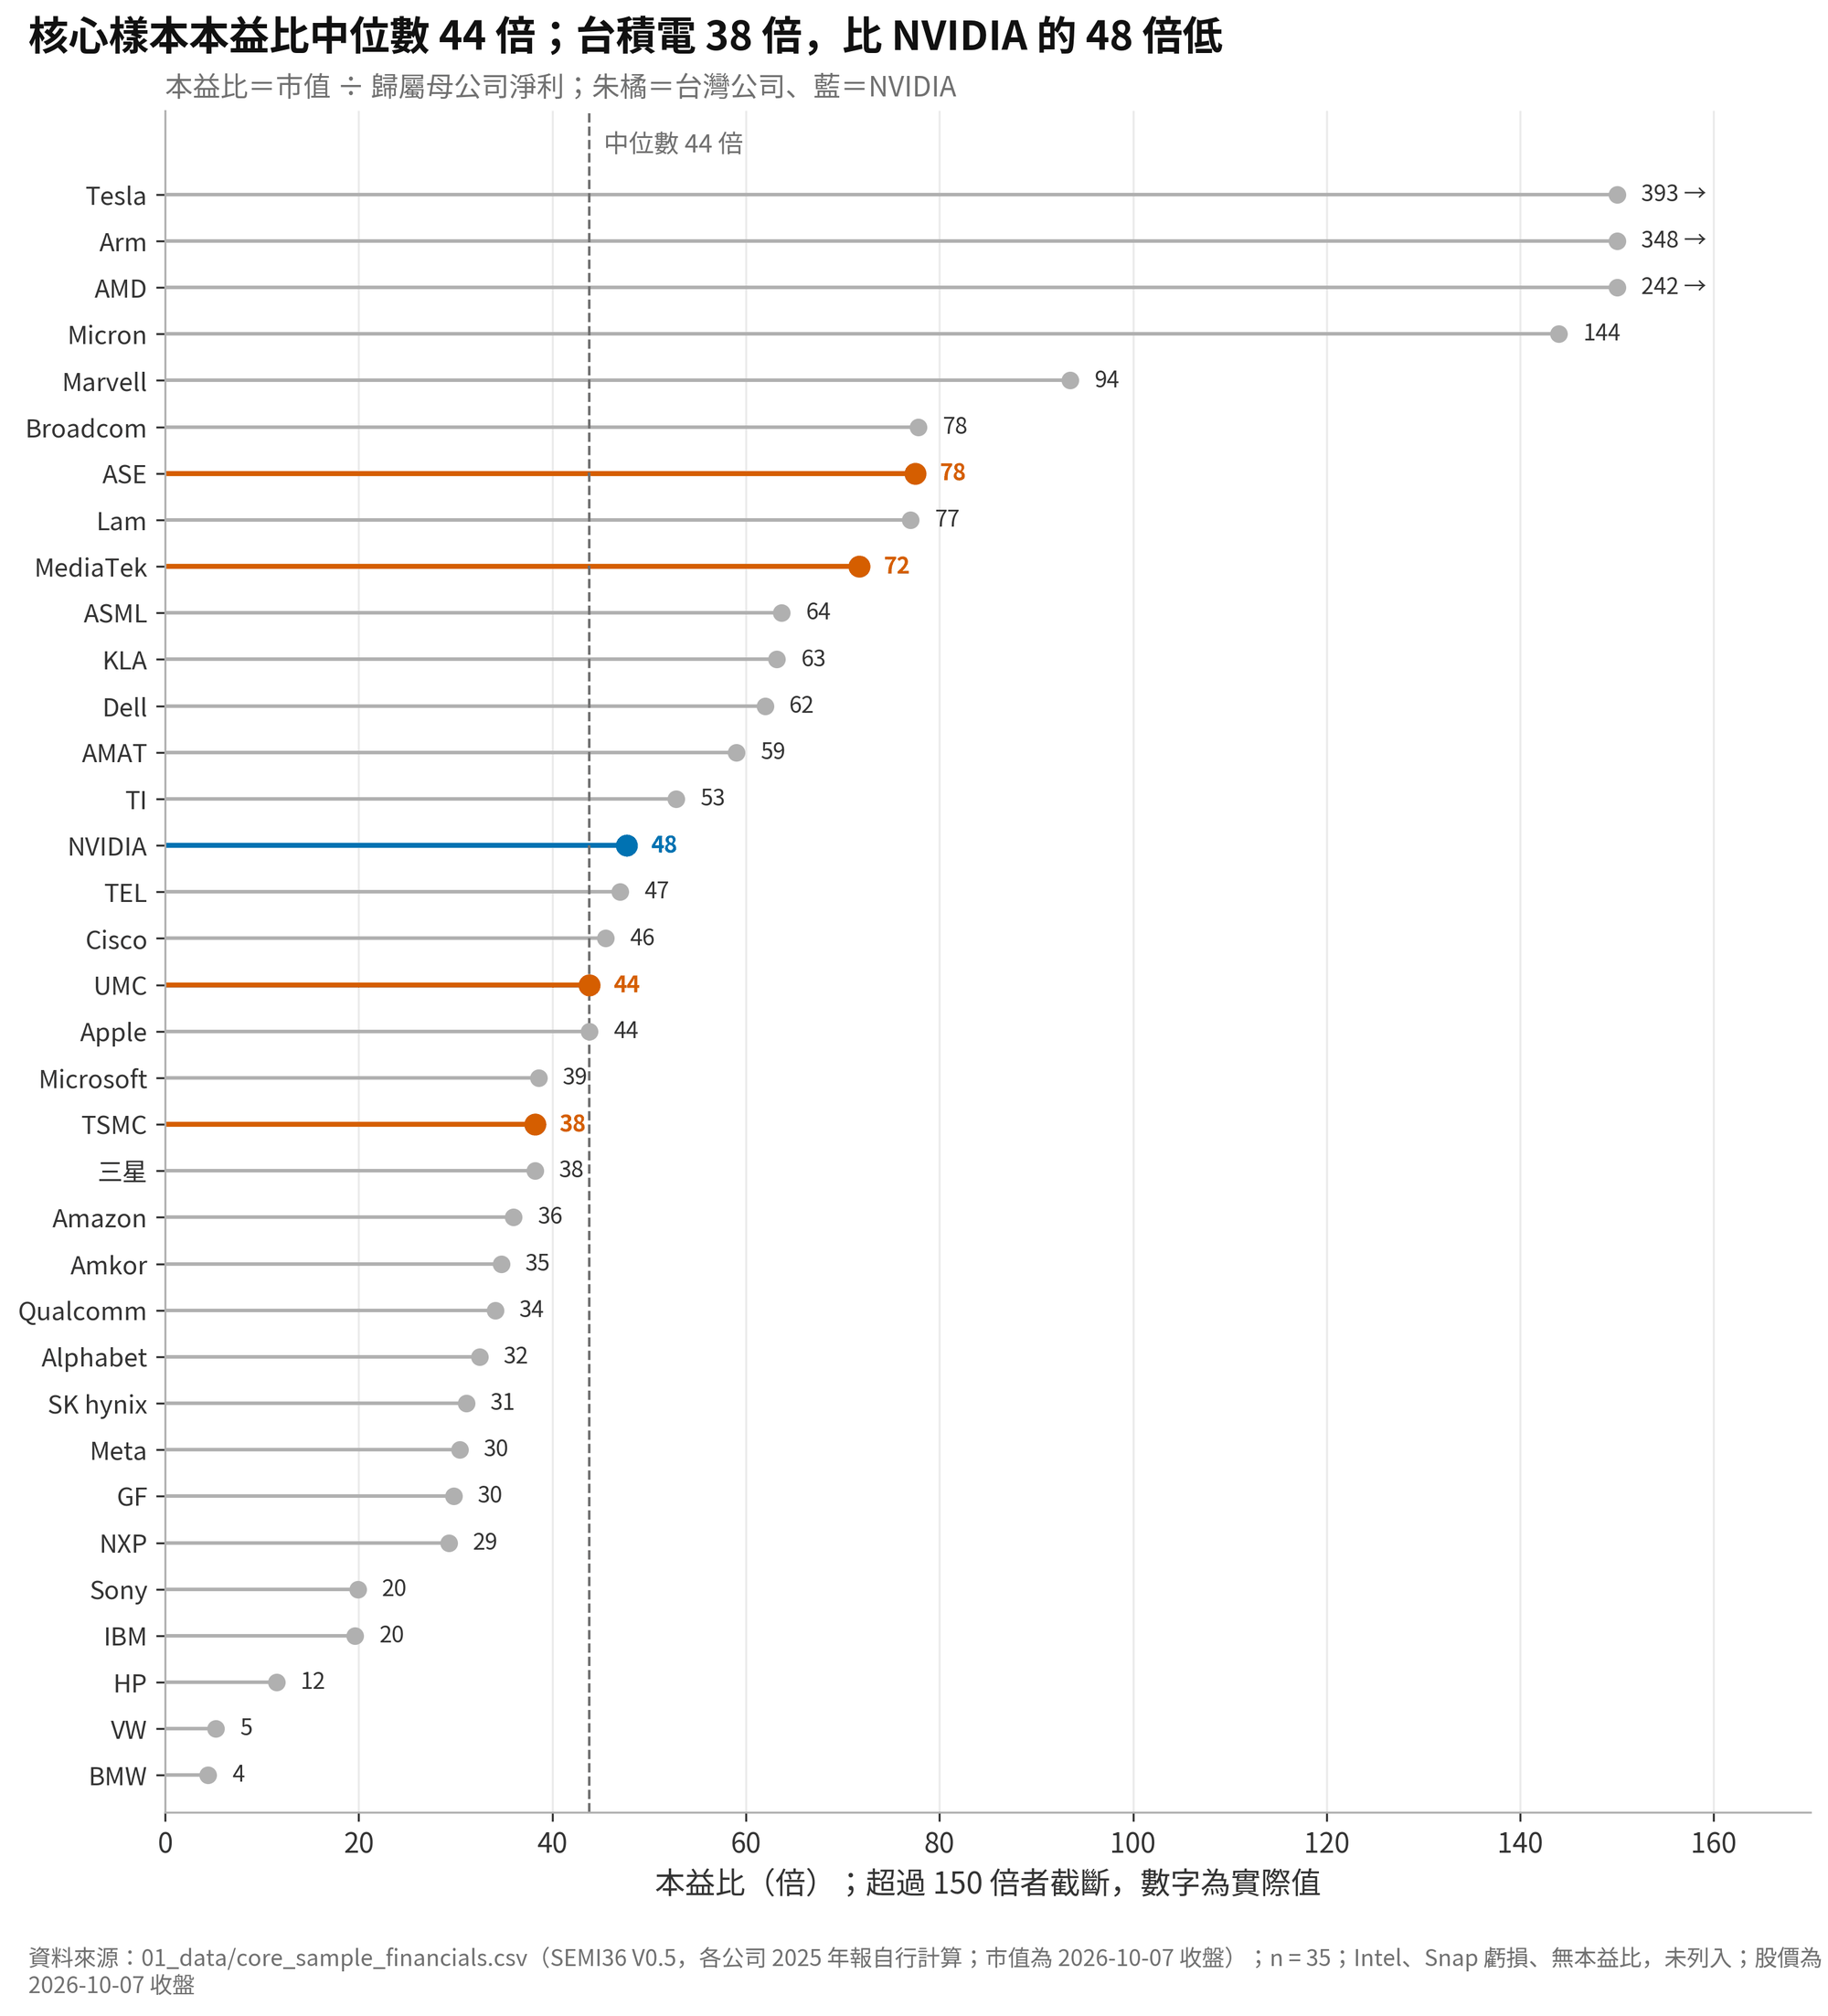
35 家公司如果用粗長條,畫面會被墨水塞滿;細線加圓點,把注意力放在端點的數值上。本益比超過 150 倍的公司(最高是 Tesla 的 393 倍)截斷畫在 150,用箭頭表示實際更高,並寫上實際值;不截斷的話,其他公司全會擠在左邊。Intel、Snap 當年虧損,本益比沒有意義,不畫成 0 或負值,而是寫在圖註。
本益比高不等於貴:它可能反映市場預期獲利高成長,也可能只是當年獲利特別低、分母特別小。截斷軸是為了可讀性,但一定要標示清楚,否則讀者會以為最高的只有 150 倍。另外,股價是 2026 年 10 月、淨利是 FY2025,這是「落後本益比」,兩者並不是同一時間。
七、凹凸線圖:先掉再爬的路徑
台灣半導體公司 2021 到 2025 年的營收排名怎麼變動?誰爬得最快?
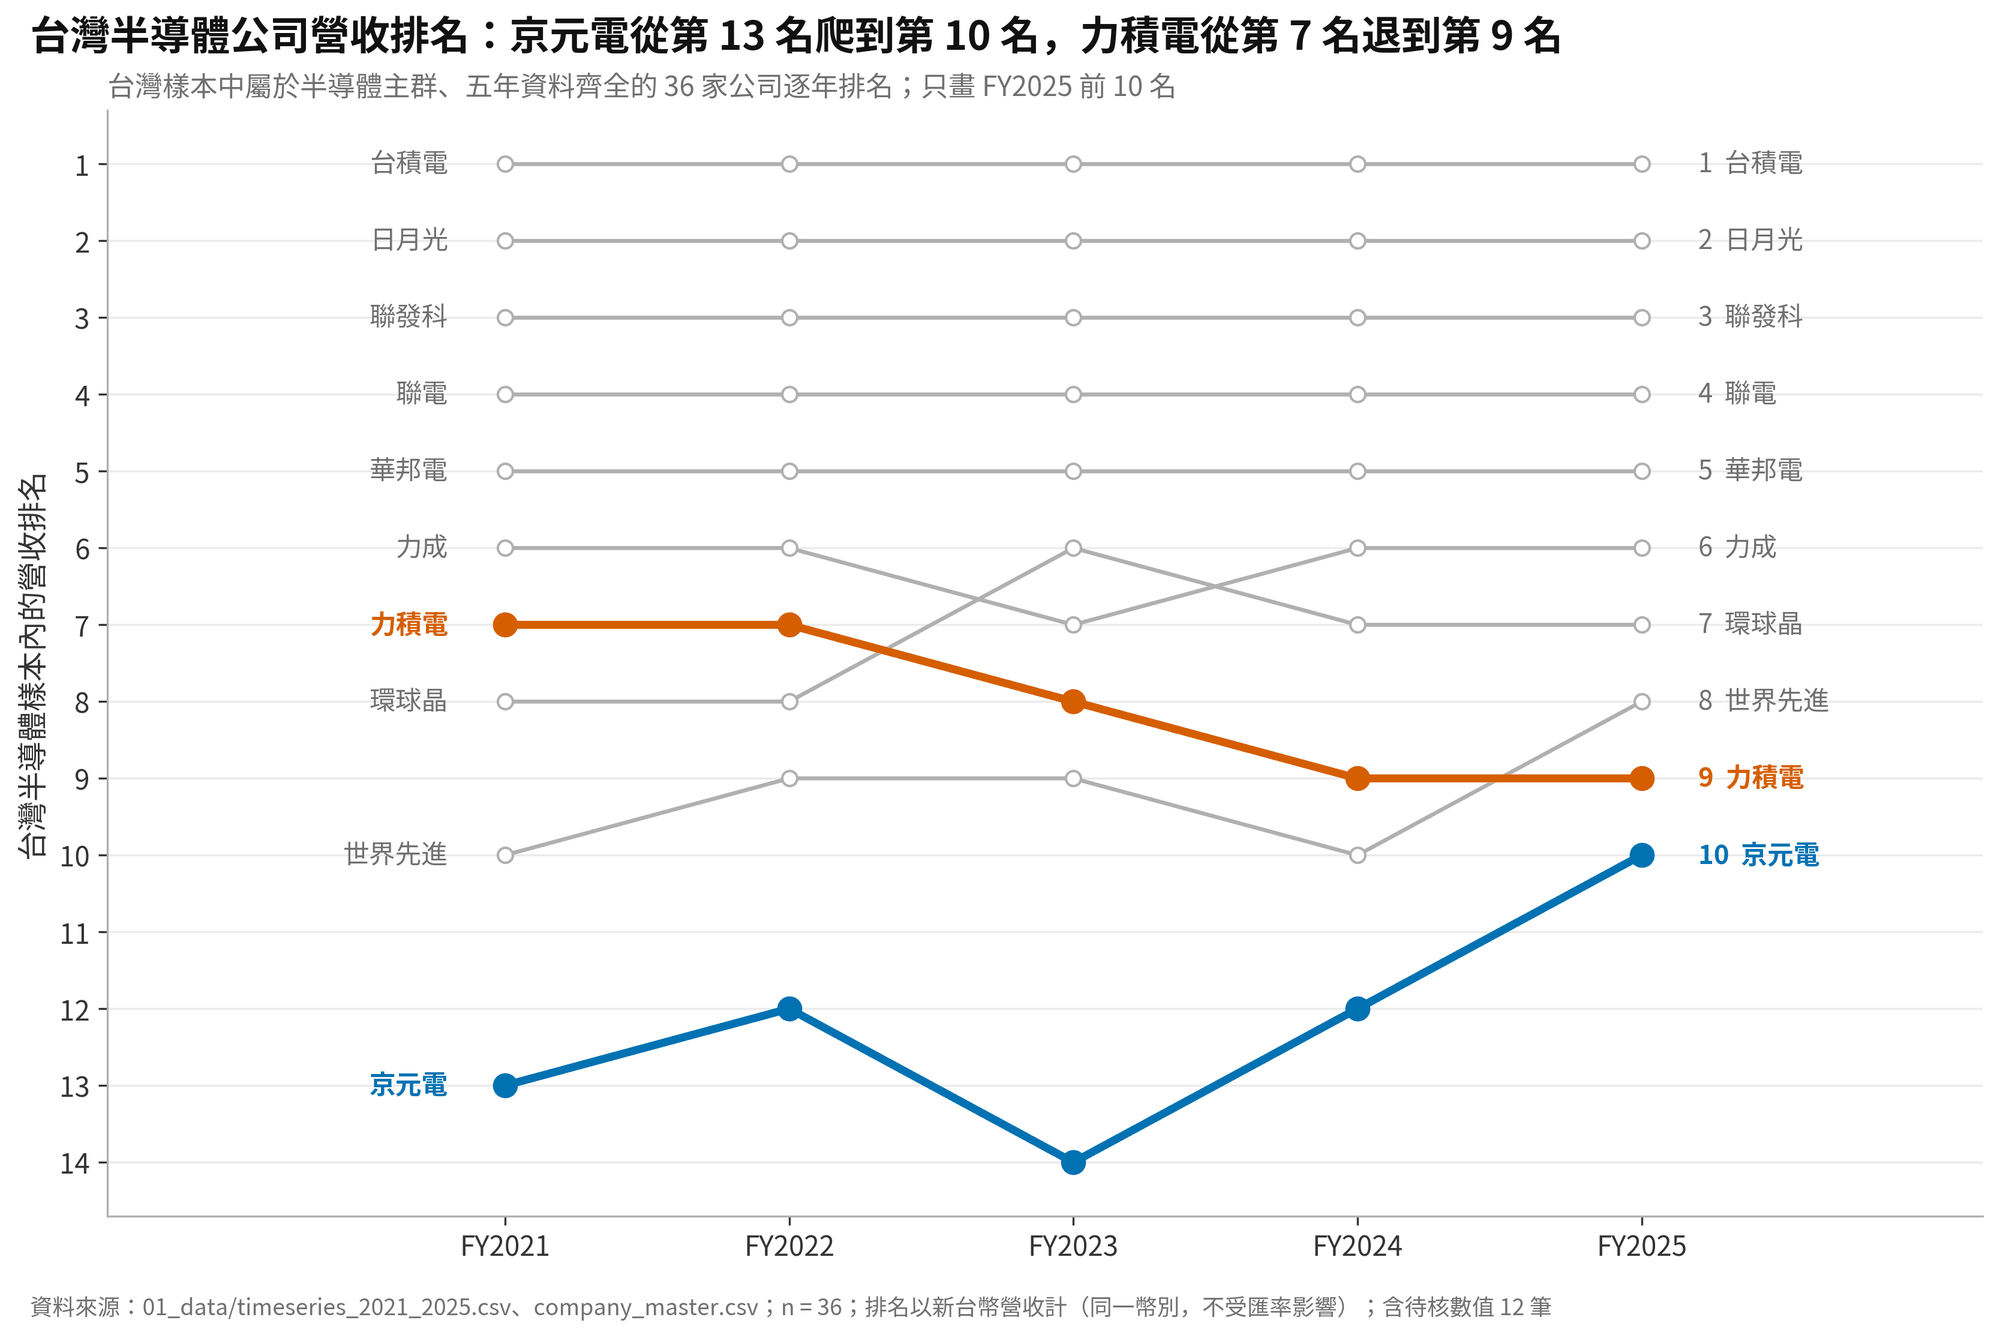
和坡度圖相比,凹凸線圖保留了中間每一年,看得到「先掉再爬」這種路徑。但這張圖選的是「FY2025 前 10 名」,這個選擇本身就會讓圖偏向最後贏的人:曾經在前 10 名、後來掉出去的公司,就從圖上消失了。這是典型的倖存者偏差。名次也不等於規模,第 1 名台積電和第 2 名的營收差距,可能比第 2 名到第 10 名的總和還大。線太多也會讀不動,超過 10 條,凹凸線圖就會變成一盤義大利麵。
八、為什麼我們這麼愛排名
排名是一種極有效率的資訊壓縮:它把一堆數字變成一個位置,讓人不需要理解數值,就知道誰在前面。這也是為什麼大學排名、富豪榜、熱銷排行榜永遠有人看。
但這種壓縮的代價很高。第一,排名把「差距」這個最重要的資訊丟掉了:第 1 名和第 2 名可能差 10 倍,也可能只差 1%。第二,排名是一種相對評價,會讓人忽略絕對水準:全部的人都在進步,排名卻一定有人退步。第三,排名會改變被排名者的行為:當某個指標被拿來排名,大家就會開始優化那個指標本身,而不是它原本想衡量的東西,這就是古德哈特定律(Goodhart’s law)的日常版本。
結語:三件事
先排序再畫。 讀者不該自己找誰第一。
排名會藏起差距。 第 1 名和第 2 名可能差 10 倍,也可能只差 1%。
樣本決定排名。 「前 10 大」永遠要問:是哪一份名單的前 10 大?
下一篇,D06 談分佈:當我們說「平均淨利率 13%」,我們丟掉了什麼。
資料來源與說明
圖型分類與定義:FT Visual Vocabulary(© Financial Times,CC BY-SA 4.0)。
財務數據:91 家半導體產業鏈公司 FY2021–2025 財報,以 2025 年平均匯率換算。
市值與本益比:2026 年 10 月 7 日收盤價,以當日匯率換算。
市場資料:WSTS 2025 年實際值。