


研發花得多的公司,毛利率就比較高嗎?看到兩條線一起動,先別急著說「因為」。
FT Visual Vocabulary 的第二欄是「相關性」(Correlation),定義是:呈現兩個以上變數之間的關係。FT 在這一欄特別加了一句警語:除非你另外說明,很多讀者會以為你畫出來的關係就是因果。FT 常拿它畫通膨與失業、所得與平均壽命。
一、散布圖:關係的方向、強弱與例外
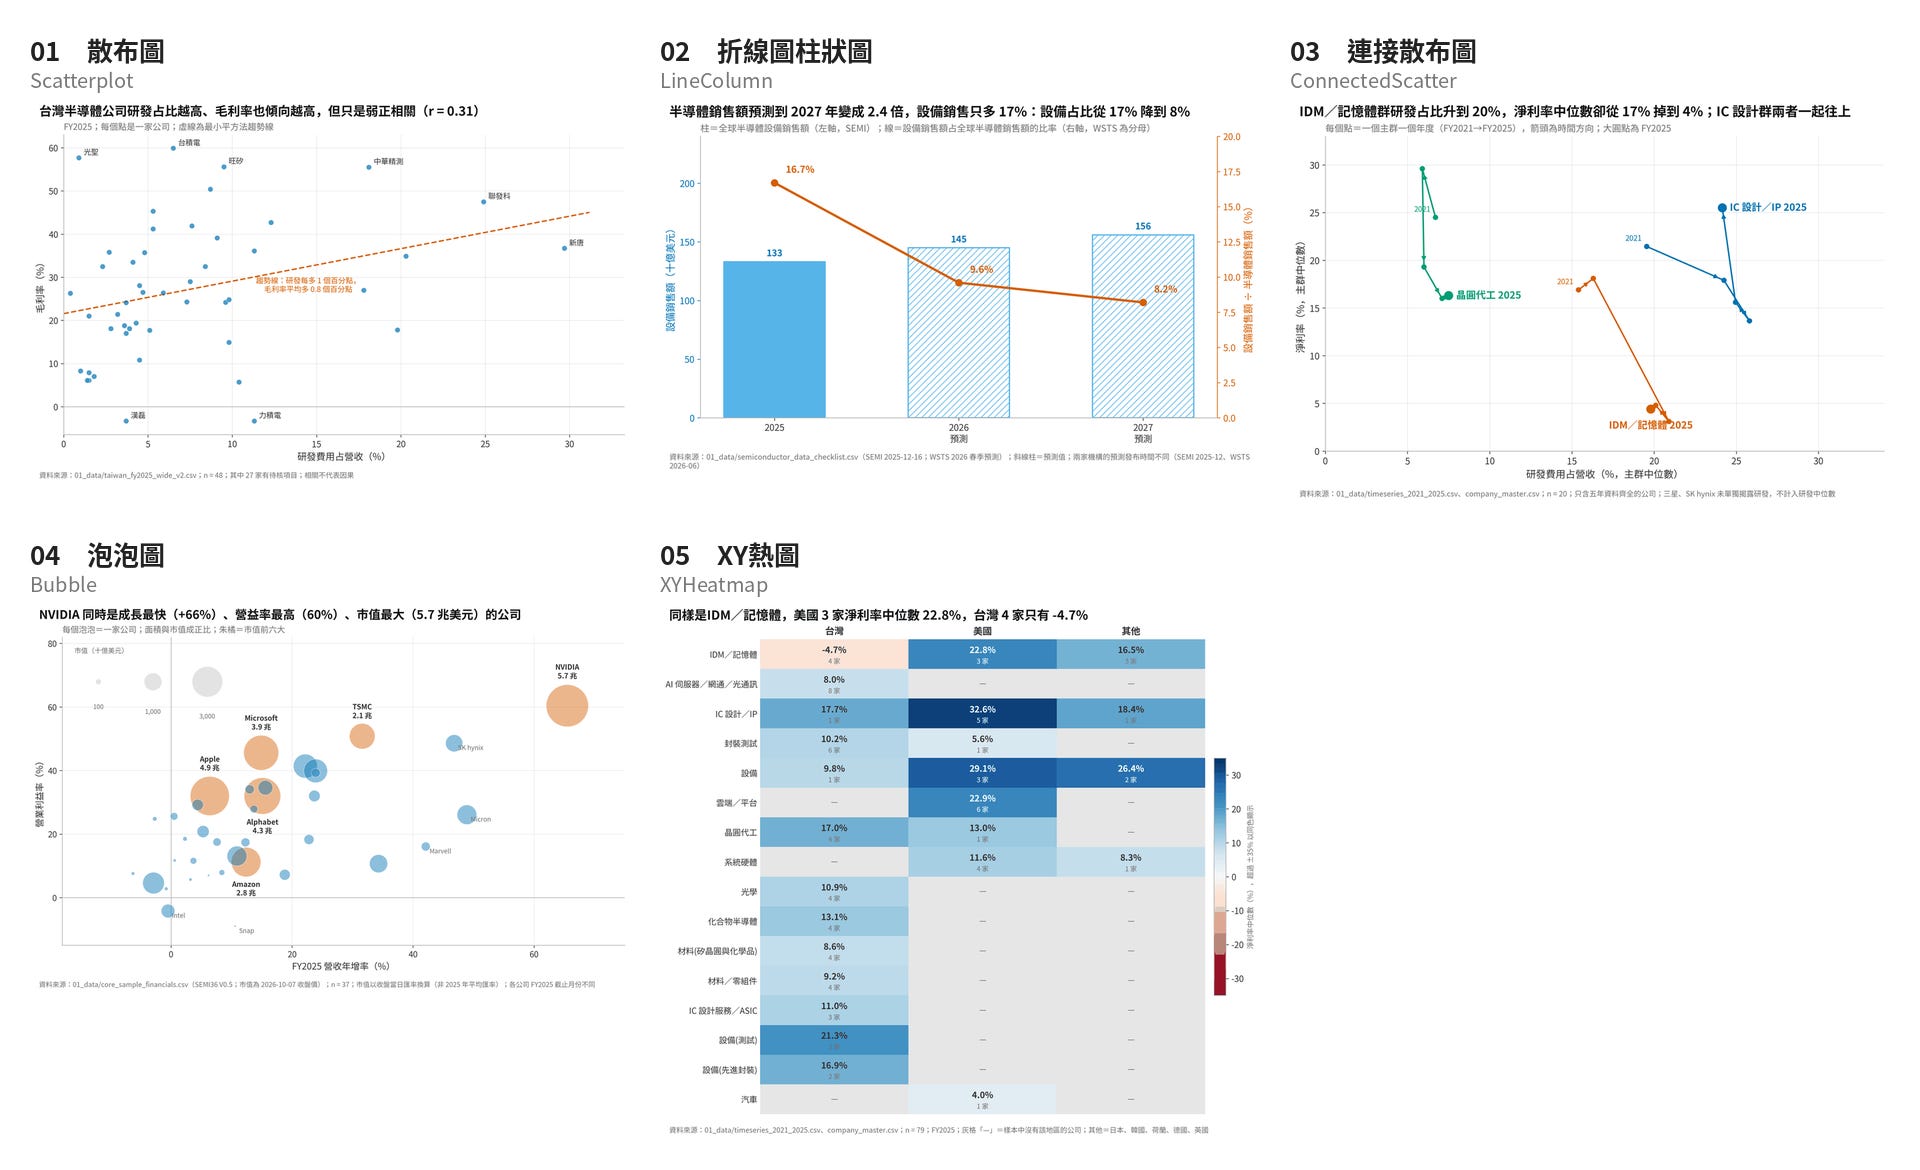
研發投入比較多的台灣半導體公司,毛利率是不是也比較高?
散布圖是 FT 所說「展現兩個連續變數關係的標準方式」:每家公司一個點,關係的方向、強弱與例外一次看到。趨勢線的斜率是 0.75,也就是研發占營收每多 1 個百分點,毛利率平均多 0.8 個百分點;但相關係數只有 0.31,是弱正相關。高於趨勢線最多的是光聖、台積電、旺矽,同樣的研發強度下毛利特別高;低於趨勢線最多的則是力積電、漢磊、富采。
這張圖有三個陷阱。第一,相關不是因果:可能是「毛利高,所以有錢做研發」,而不是「做研發,所以毛利高」;也可能兩者都由第三個變數決定,例如「做 IC 設計」這個商業模式。第二,商業模式混在一起:IC 設計公司天生研發占比高、沒有工廠,代工廠研發占比低、資本支出高,分群畫的結論可能和合在一起畫完全不同,這就是辛普森悖論的入口。第三,r 對極端值很敏感:拿掉右上角幾家公司,r 會明顯下降。
二、連接散布圖:把時間串進關係裡
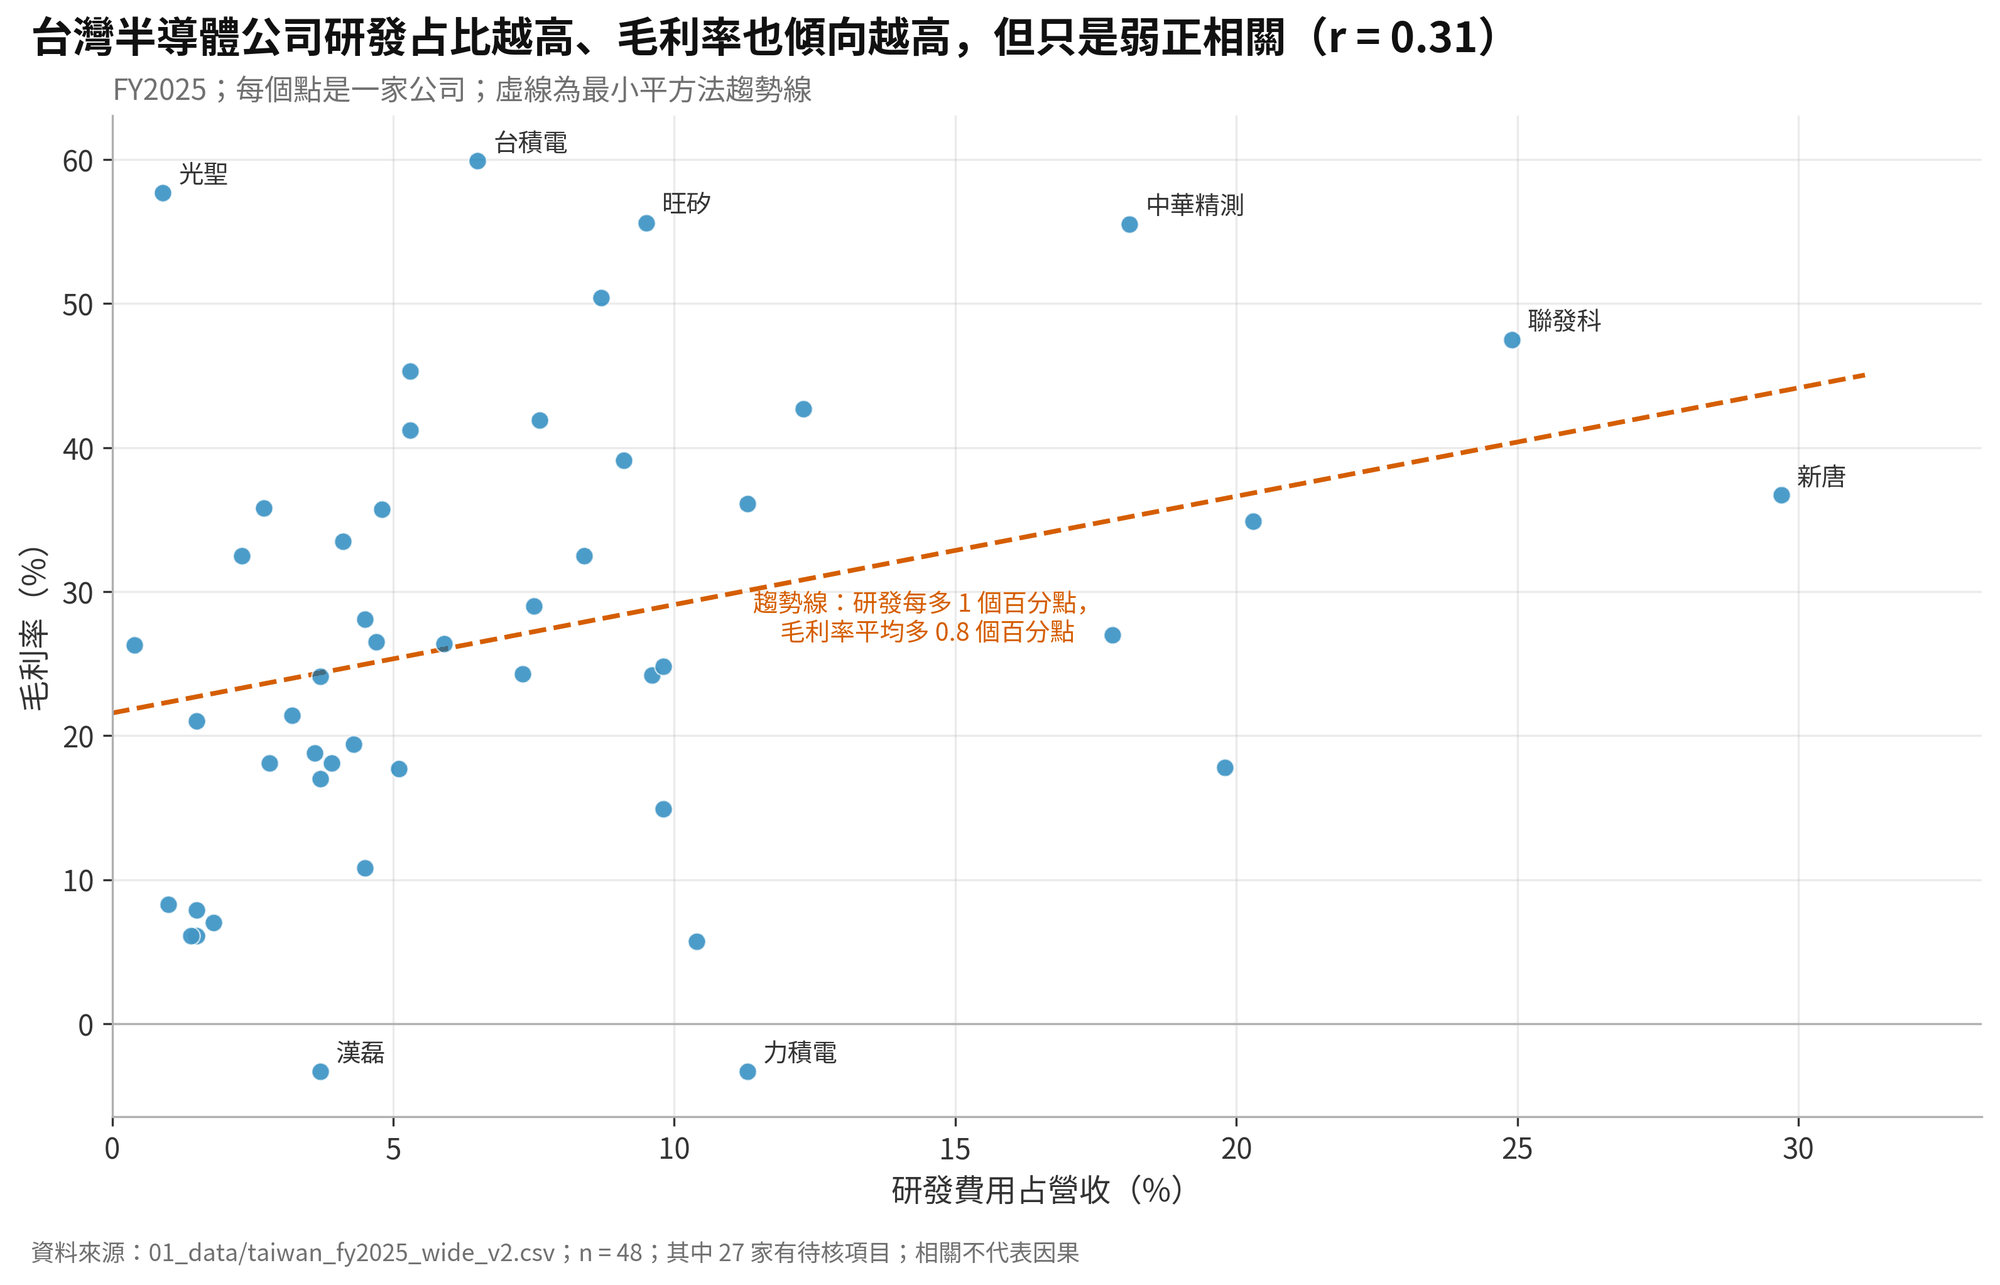
研發投入變多,獲利有沒有跟著變好?三個產業群五年的路徑各往哪裡走?
散布圖只看關係;把同一群的五個年度連起來,就多了一條時間路徑。往右下走(投入多、獲利少)和往右上走(投入多、獲利多),是兩種完全不同的故事。以各群的中位數來看,從 FY2021 到 FY2025,IC 設計群的研發占比從 20% 升到 24%,淨利率從 21% 升到 26%;晶圓代工群研發從 7% 到 8%,淨利率從 24% 降到 16%;IDM 與記憶體群研發從 15% 升到 20%,淨利率卻從 17% 掉到 4%。
這裡最重要的陷阱是:研發占比上升,可能只是營收下降。比率的分母變小,比率自然變大;IDM 群在 2023 年研發占比跳升,同一年營收也在縮水。要分辨是「研發變多」還是「營收變少」,得回頭看研發金額本身。此外,每一年的中位數可能是不同的公司,所以這條路徑不是某一家公司的軌跡;有些公司(例如三星、SK hynix)沒有單獨揭露研發,研發與淨利率的中位數其實來自不同家數。
三、XY 熱圖:空格本身就是資訊
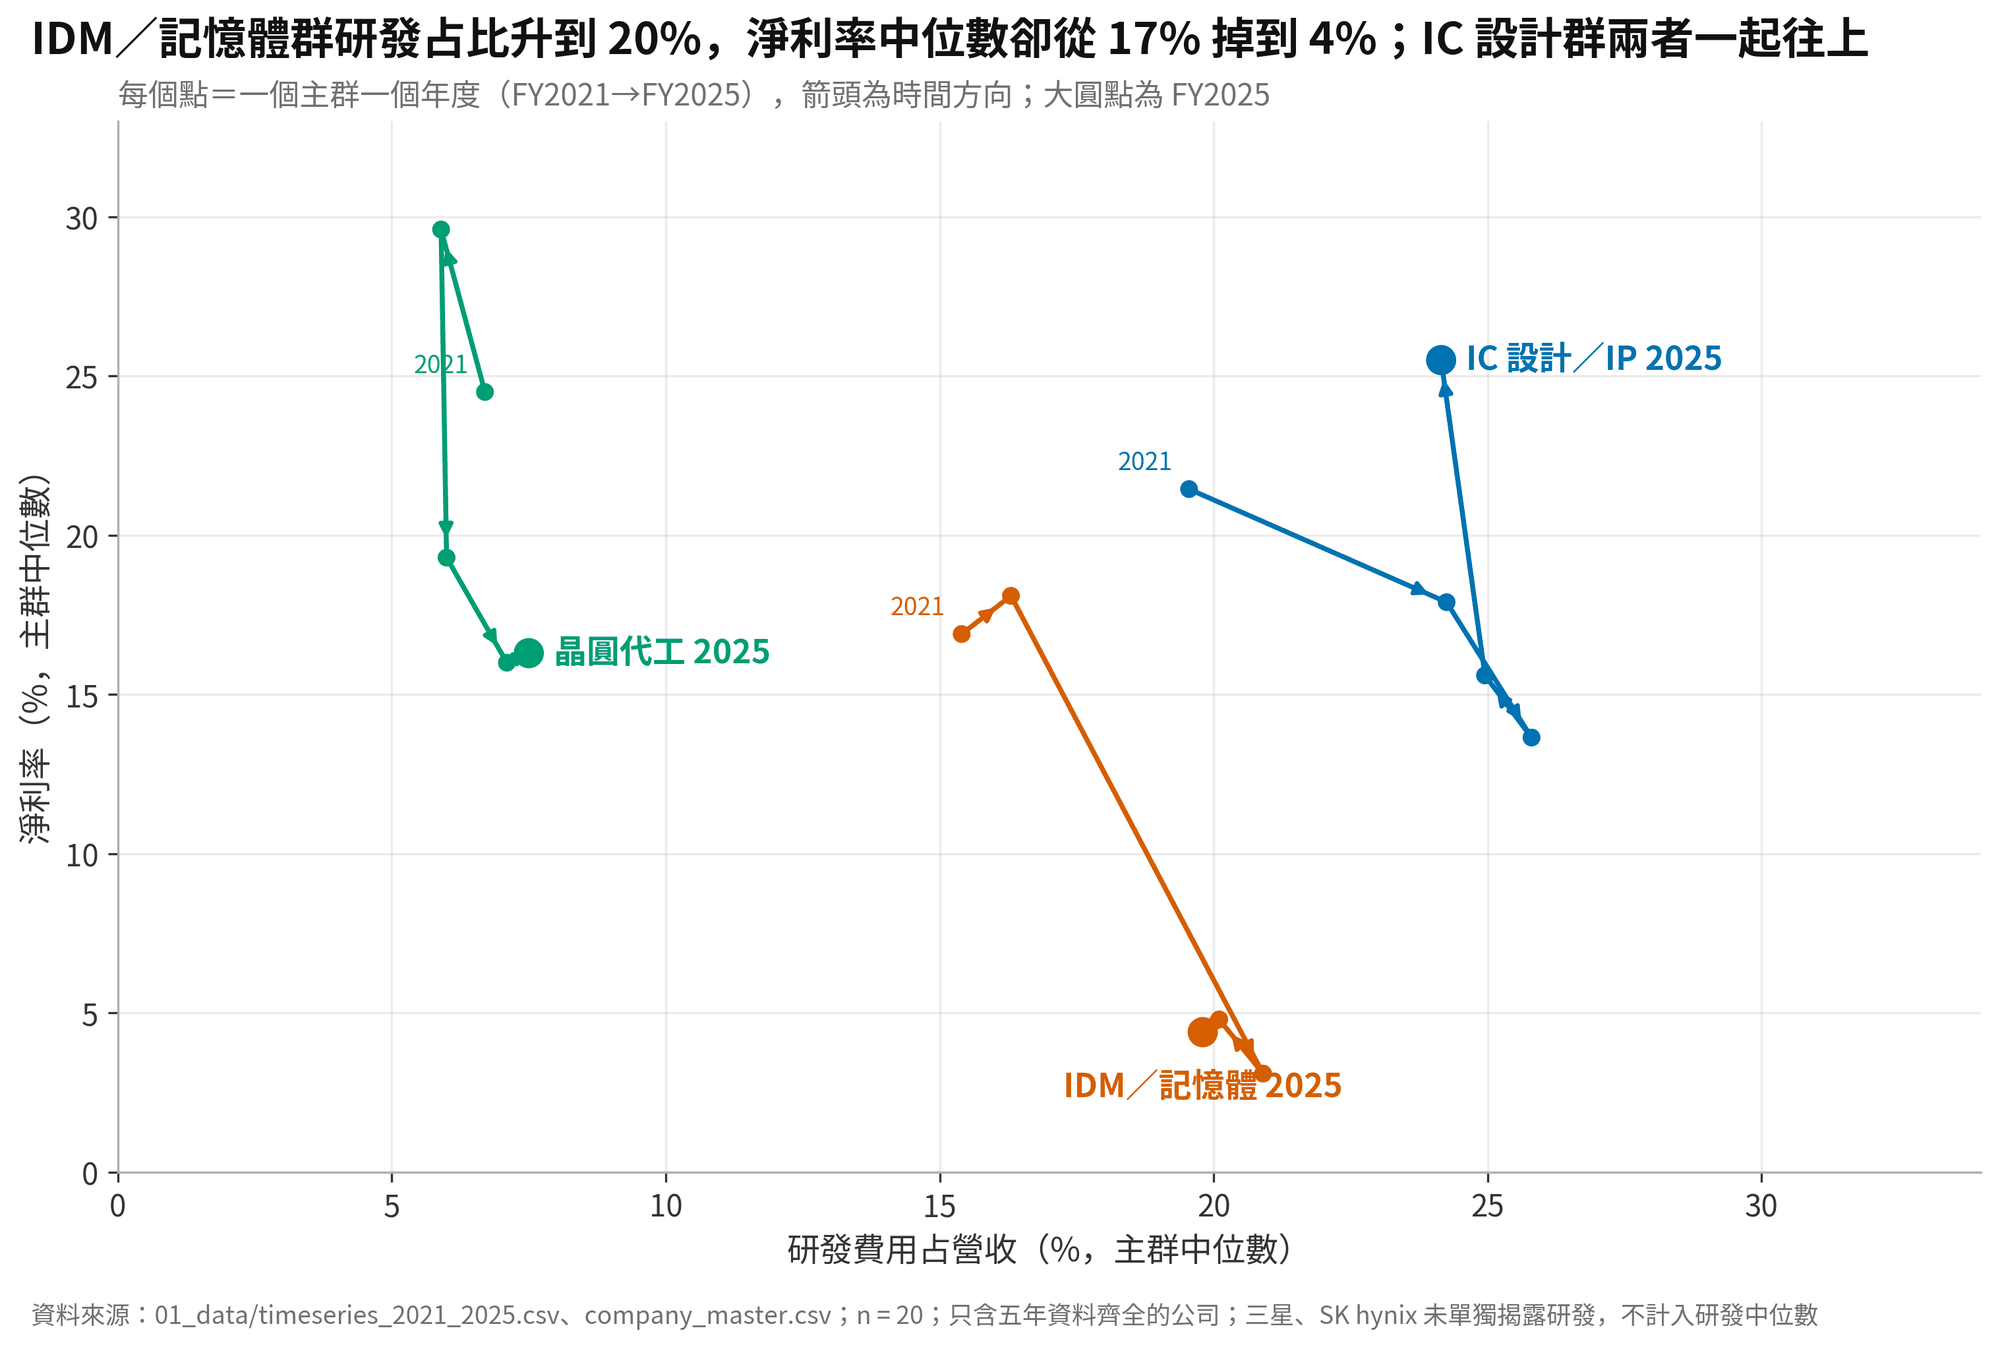
同一個產業群,不同國家的公司賺錢能力差多少?哪些格子根本沒有公司?
兩個類別變數(產業群 × 地區)交叉成格子,用顏色看高低,用數字補足精確度。16 個產業群乘上 3 個地區,共 48 格,其中 23 格是空的。空格本身就是資訊:雲端與平台只有美國公司,光學、化合物半導體、材料只有台灣公司,這反映的是樣本怎麼挑,也反映了產業的地理分工。
這張圖最重要的一課是小樣本。很多格子只有一兩家公司,「中位數」就是那一兩家的數字,所以每一格都必須標出家數,讀者才知道哪些顏色可信。再來是組成效應:IDM 與記憶體群的台美差距,可能來自公司組成不同(美國這格是 Intel、Micron、TI,台灣則是規模較小的記憶體、MCU 與功率元件廠),而不是「國家」本身。最後,色階的上下限也是作者選的:超過 ±35% 的格子顏色一樣深,改成 ±60%,多數格子就會變淡。
四、折線+柱狀:一個數量與一個比率
全球半導體銷售額預測倍增,買設備的錢有沒有跟著倍增?
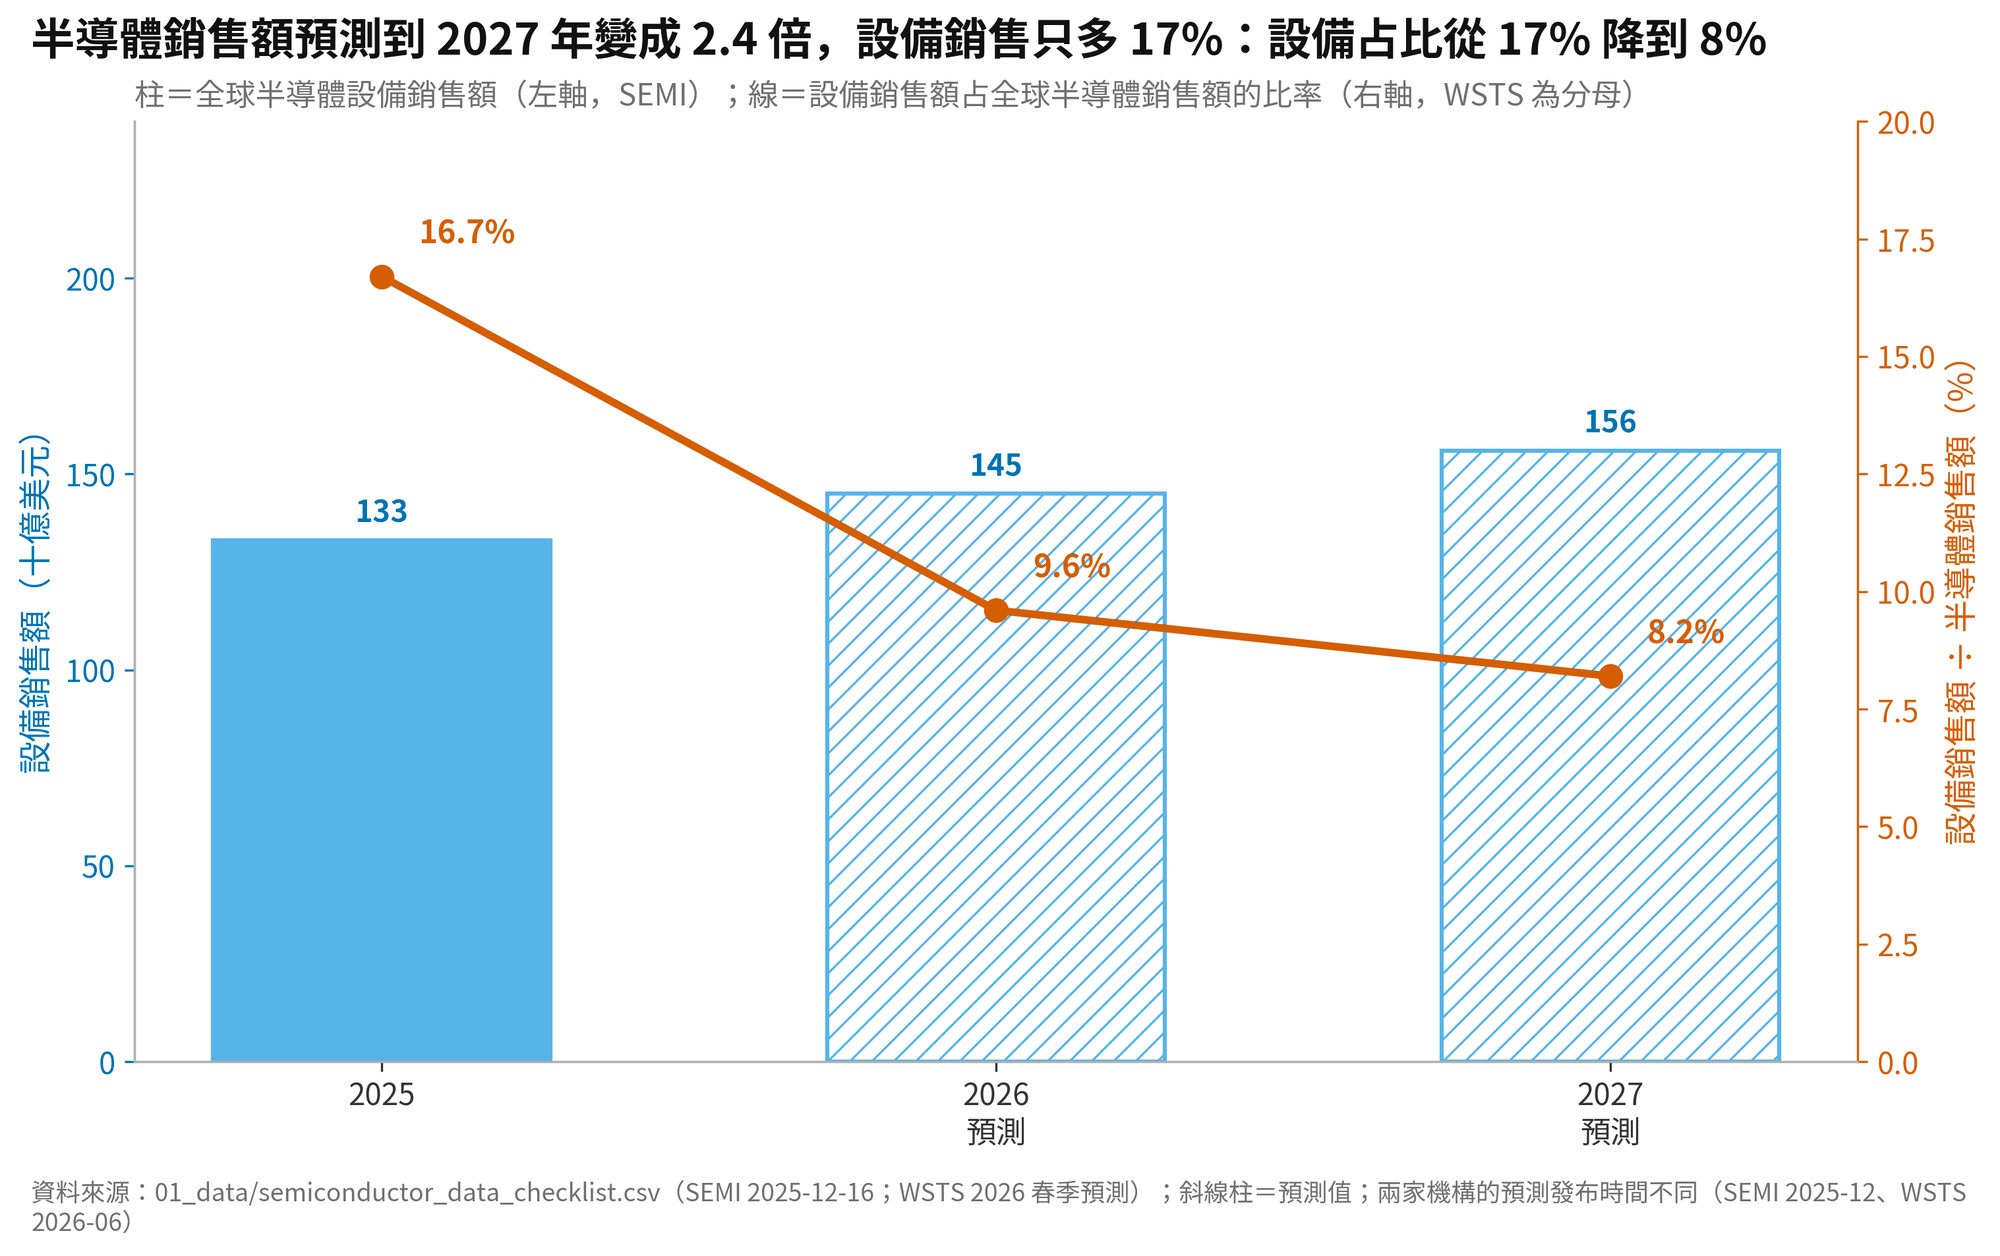
FT 在相關性這一欄說,折線加柱狀「能展示一個數量(柱狀圖)和一個比率(折線圖)的關係」。柱子看設備市場本身有多大,線看它相對於整個半導體市場的比重,兩者方向相反,正是這張圖要說的故事。2026 年銷售額的跳升主要來自記憶體漲價,而漲價不需要多買機台,所以「設備/銷售」的比率被分母稀釋;如果成長來自出貨量,設備投資通常會跟上。這個比率因此可以當成「這一波是量還是價」的粗略指標。
陷阱有三個:雙軸的刻度是作者選的,線與柱的相對高低沒有意義;設備預測與銷售預測是不同機構、不同時間發布的,分子和分母不是同一時間的判斷;而且只有三個點,其中兩個還是預測。
五、泡泡圖:第三個變數
市場給高市值的公司,是因為它們長得快,還是賺得多?
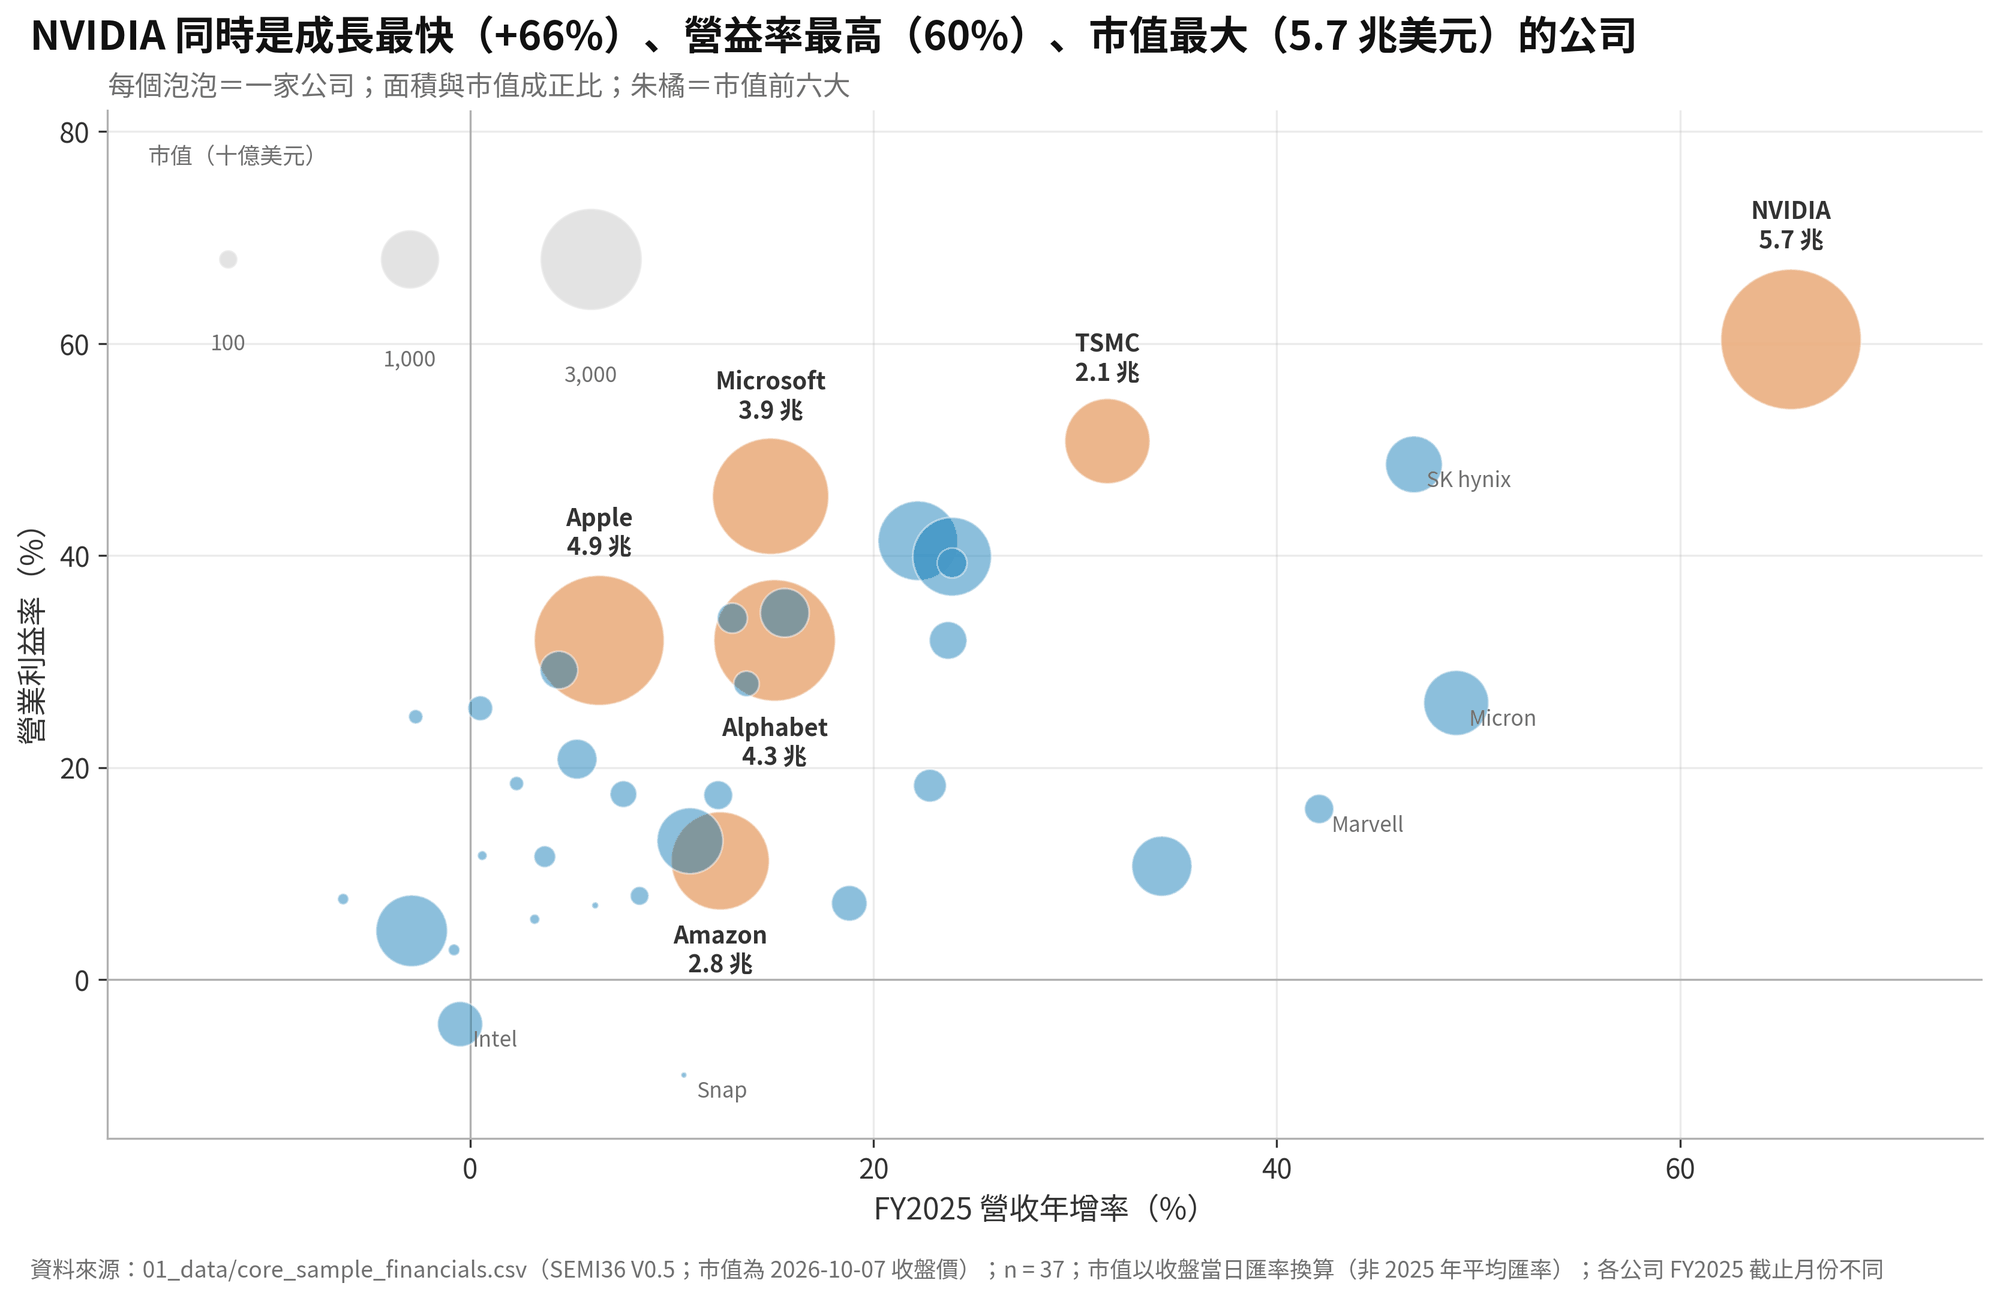
泡泡圖和散布圖類似,只是用泡泡大小顯示第三個變數:X、Y 是兩個績效指標,泡泡大小是市場的評價。在核心樣本 37 家公司中,市值(取對數)與營收年增率的相關係數是 0.50,與營業利益率是 0.61;右上角又快又賺的泡泡普遍偏大,左下角幾乎都是小泡泡。
泡泡圖的陷阱,第一篇就談過:泡泡的面積必須與市值成正比,若用半徑對應市值,3 倍市值會畫成 9 倍大。其他幾個陷阱是:大泡泡會蓋住小泡泡,所以要先畫大的、再畫小的,並使用半透明;市值是 2026 年 10 月初的收盤價,財務數字卻是 FY2025,兩者時間不同;而核心樣本本來就偏向大公司,在這個樣本裡找到的關係,不一定適用於所有半導體公司。
六、為什麼我們這麼容易把相關讀成因果
人類的大腦天生是一台找因果的機器。看到兩件事一起發生,我們會自動補上一個「因為」,這在演化上很合理:寧可錯把風吹草動當成老虎,也不要錯過真的老虎。但在資料分析裡,這個本能是陷阱。
經濟學裡最常見的三種「假因果」,在這一篇都出現了。反向因果:是研發帶來高毛利,還是高毛利養得起研發?遺漏變數:商業模式同時決定了研發比率與毛利率。選擇偏誤:核心樣本本身就是「成功的公司」,在成功者之間找到的關係,不代表做了同樣的事就會成功。這和「成功人士都早起,所以早起會成功」是同一種推論。
結語:三件事
相關不等於因果。 第三個變數(規模、產業別)常同時影響兩者。
散布圖要寫 r 與 n。 一兩個離群值,就能做出或毀掉一個相關。
雙軸圖最容易製造「假相關」。 兩個刻度都是作者選的。
下一篇,D05 談排序:排名讓人一眼找到位置,也讓人忘了彼此差多少。
資料來源與說明
圖型分類與定義:FT Visual Vocabulary(© Financial Times,CC BY-SA 4.0)。
財務數據:91 家半導體產業鏈公司 FY2021–2025 財報,以 2025 年平均匯率換算;台灣公司 FY2025 全年財報。
市場資料:WSTS 2026 年春季預測;SEMI 設備市場預測(2025 年 12 月)。
市值:2026 年 10 月初收盤價,以當日匯率換算。